[Paper] AlexNet: ImageNet Classification with Deep CNN
Introduction
초기 객체 인식 분야는 머신러닝 기법에 주로 의존하였고, 성능 향상을 위해서 더 많은 양의 데이터셋, 더 깊은 모델, 과적합을 방지하기 위한 고도화된 학습 기법이 필요하게 되었음.
CNN은 FFN보다 더 적은 파라미터와 복잡성으로 학습하기 쉬움에도 불구하고 성능차이가 적다는 장점이 있지만, 고해상도와 같은 이미지에 대해서는 비용이 많이 들어감.
기존의 얕은 CNN 으로는 큰 모델을 학습하기에는 충분하지 않았기에, 더 깊은 구조를 가진 모델을 필요로 함.
그 당시 GPU의 발전으로 인해 최적화된 2d convlution 연산을 병렬 처리할 수 있게되어 깊은 모델을 구현할 수 있게 됨.
ReLU activation function, GPU 병렬처리, Drop-out, 데이터 증강 등 당시 기준으로 혁신적인 구성 요소들을 효과적으로 통합했다는 것에 의의가 있음.
Dataset
ImageNet Overview
ImageNet Dataset 은 2만2천개의 카테고리가 있는 150만개의 고해상도 이미지임.
120만개의 train dataset, 5만개의 validation dataset, 15만개의 test dataset을 제공함.
Data pre-processing
- 256 x 256 고정된 크기로 맞춰 모델에 입력함
- 256 x 256 의 저강삭형 이미지를 얻기 위해 rescale한 사진의 center만 crop하여 이미지를 구축함
- 각 픽셀의 RGB 값을 전체 이미지의 RGB 평균으로 빼 정규화된 입력을 사용함
Architecture
ReLU Nonlinearity
Limitations of Traditional Activation Functions
전통적인 tanh(x) 나 sigmoid 함수와 같은 activation function 들은 입력의 절댓값이 크면, gradient가 0으로 수렴하게 됨.
이로 인하여 학습속도가 느려지게 되고, gradient vanishing 문제가 발생함.
큰 입력값에 대한 대부분의 출력이 위와 같이 포화(saturating, 기울기가 0으로 수렴)구간에 머물게 됨.
ReLU (Rectified Linear Unit)
ReLU(Rectified Linear Unit) 함수는 인공신경망에서 입력값이 0보다 크면 그대로 출력하고 0 이하면 0을 출력하는 활성화 함수임.
saturating한 활성화함수를 사용하는 것보다 ReLU와 같은 non-saturating한 활성화함수를 사용하는 것이 학습속도 측면에서 매우 빠름.
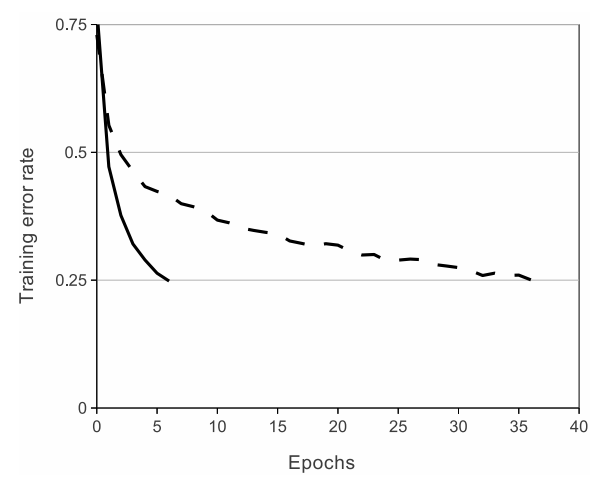
ReLU(실선)을 사용하는 것이 6 epoch 으로 training error 25%에 도달했지만, tanh(점선)은 같은 수준에 도달하는데 38 epoch가 필요함을 볼 수 있음.
Training on Multiple GPUs
저자들이 학습에서 사용한 GPU는 GTX580 으로 3GB 메모리 제한으로 인해 120만장의 이미지를 학습하기에 제약이 있어, 2개의 GPU를 병렬로 학습하여 학습을 수행함.
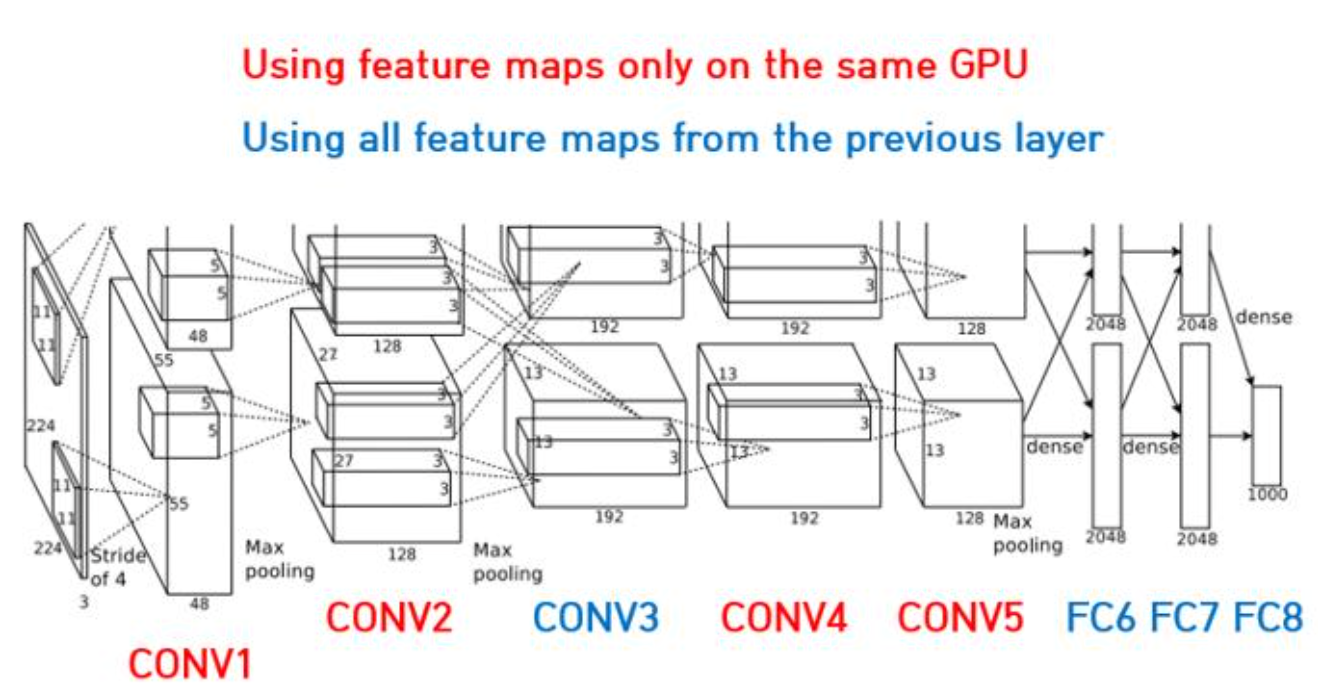
하나의 Conv Filter는 하나의 출력 feature map을 만듦.
예를 들어 Conv1에 필터가 96개 있으면, $224\times224\times3 \rightarrow 55\times55\times96$ 처럼 96개의 feature map이 생김.
Alexnet은 이 96개를 두 GPU에 나눠 병렬로 계산함.
- Conv2: 같은 GPU의 Conv1 feature map만 사용
- Conv3: 두 GPU의 Conv2 feature map 전부 사용
- Conv4: 같은 GPU의 Conv3 feature map만 사용
- Conv5: 같은 GPU의 Conv4 feature map만 사용
- FC: 다시 전체가 연결됨
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
                 입력 이미지
                     │
          ┌──────────┴──────────┐
          ↓                     ↓
        GPU 1                  GPU 2
      Conv1 절반              Conv1 절반
          │                     │
          ↓                     ↓
      Conv2 절반              Conv2 절반
          │                     │
          └────────┬────────────┘
                   │
            ★ Conv3에서 통신 ★
          두 GPU 정보를 모두 봄
                   │
          ┌────────┴────────┐
          ↓                 ↓
        GPU 1             GPU 2
       Conv3              Conv3
          │                 │
       Conv4              Conv4
          │                 │
       Conv5              Conv5
          │                 │
          └───────┬─────────┘
                  ↓
              FC layers
                  ↓
             1000 classes
LRN (Local Response Normalization)
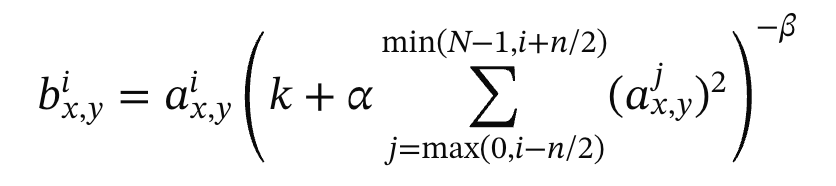
$a^i_{x,y}$ : $(x,y)$ 위치에서 $i$번째 커널(출력 채널)을 통해 계산된 값에 ReLU를 적용한 activation 값
$b^i_{x,y}$ : $a^i_{x,y}$에 LRN(Local Response Normalization)을 적용한 이후의 값
$i$ : 현재 정규화하려는 출력 채널의 인덱스
$j$ : 주변 채널들을 순회하기 위한 인덱스
$N$ : 해당 레이어에 존재하는 전체 출력 채널(feature map)의 수
$n$ : LRN을 적용할 주변 채널의 범위(window size)를 결정하는 하이퍼파라미터
$k$ : 분모가 너무 작아지는 것을 방지하기 위해 더해주는 상수
$\alpha$ : 주변 채널의 activation 값이 현재 activation을 얼마나 강하게 억제할지 결정하는 하이퍼파라미터
$\beta$ : 정규화의 강도를 조절하는 하이퍼파라미터
$\sum_{j=\max(0,i-n/2)}^{\min(N-1,i+n/2)} (a^j_{x,y})^2$ :
현재 채널 $i$를 중심으로 인접한 채널들의 동일한 $(x,y)$ 위치 activation 값을 제곱하여 더한 값
LRN: 모델이 과도하게 특정 뉴런에 의존하지 않도록, 이웃 채널의 출력값을 기반으로 정규화하는 기법임. 즉, 같은 위치에서 여러 채널의 뉴런들이 너무 크게 활성화되면, 서로 경쟁시키는 정규화임.
(당시에는 ReLU의 결과값이 너무 커져서 주변 뉴런에 영향을 주는 것을 방지하기 위해 정규화 기법이 필요하였음.)
예를 들어 Conv를 통과한 뒤 같은 위치에서 5개 채널의 ReLU 출력이 $[1,\;2,\;\boxed{20},\;3,\;1]$ 이라고 하자.
가운데 채널 하나만 20으로 엄청 크다. LRN은 이 20을 그대로 두지 않고, 주변 채널들의 값까지 같이 보고
$20 \rightarrow \frac{20}{\text{주변 채널들의 활성화 크기를 반영한 값}}$ 처럼 큰 값을 억제함.
ReLU는 음수를 제거하지만 양수의 활성화를 정규화하지 않기 때문에 이러한 LRN이 일반화에 도움을 줌.)
결과: Top-1 error 1.4%, Top-5 error 1.2%만큼 감소함.
Overlapping Pooling
Concepts and Background
CNN에서 Pooling Layer는 공간적 해상도의 축소 및 불변성 확보를 위한 필수 구조임.
전통적 Pooling Layer는 stride S와 window Z를 동일하게 설정함.
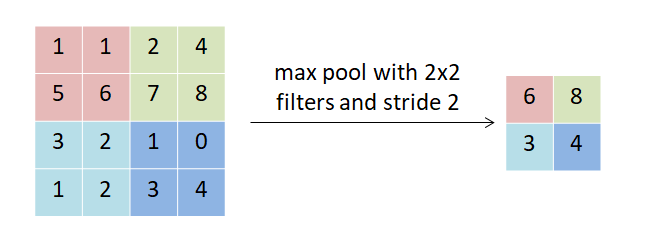
논문의 저자들은 stride < window 조건을 도입하여 겹치도록 pooling을 수행함.
Overlapping Pooling 연산을 수행: Top-1 error 0.4%, Top-5 error 0.3% 감소. (stride=2, kernel=3x3 사용)
Overall Architecture
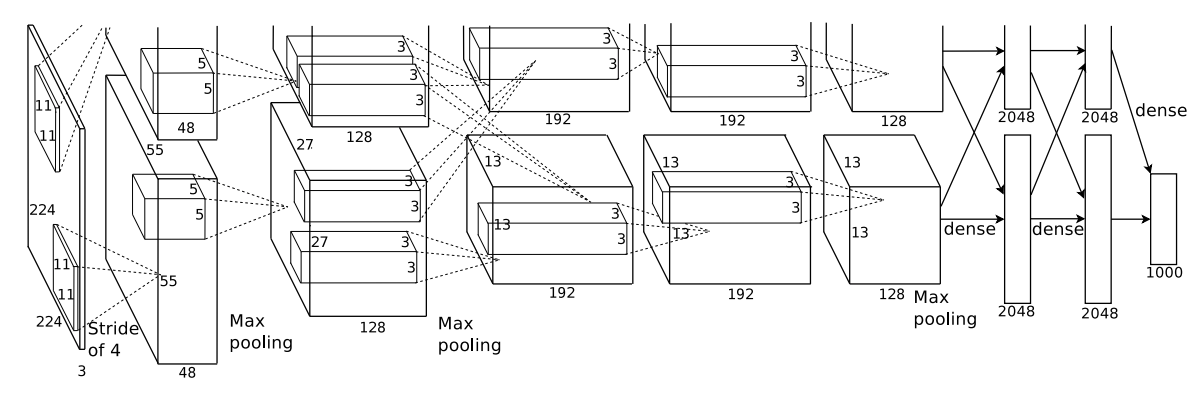
8개의 Layer로 구성됨.
- 5개의 Convolution Layers
- 3개의 Fully Connected Layers
| 단계 | 연산 흐름 | 의미 |
|---|---|---|
| Input | Input: RGB Image Output: $227 \times 227 \times 3$ | $3$은 RGB 채널 |
| Conv1 | Input: $227 \times 227 \times 3$ Filter: $11 \times 11 \times 3$ 필터 96개, stride $4$ Conv Output: $55 \times 55 \times 96$ 후처리: ReLU → LRN → MaxPool Output: $27 \times 27 \times 96$ | Edge, 색상 등 저수준 특징 추출 |
| Conv2 | Input: $27 \times 27 \times 96$ Filter: $5 \times 5$ 필터 256개 Conv Output: $27 \times 27 \times 256$ 후처리: ReLU → LRN → MaxPool Output: $13 \times 13 \times 256$ | 저수준 특징을 조합해 더 복잡한 특징 추출 (Conv2~5: padding 사용 → Conv 자체는 공간 크기 유지) |
| Conv3 | Input: $13 \times 13 \times 256$ Filter: $3 \times 3$ 필터 384개 Conv Output: $13 \times 13 \times 384$ 후처리: ReLU Output: $13 \times 13 \times 384$ | 보다 복잡한 중·고수준 특징 추출 |
| Conv4 | Input: $13 \times 13 \times 384$ Filter: $3 \times 3$ 필터 384개 Conv Output: $13 \times 13 \times 384$ 후처리: ReLU Output: $13 \times 13 \times 384$ | 특징들을 다시 조합하여 더 추상적인 특징 학습 |
| Conv5 | Input: $13 \times 13 \times 384$ Filter: $3 \times 3$ 필터 256개 Conv Output: $13 \times 13 \times 256$ 후처리: ReLU → MaxPool Output: $6 \times 6 \times 256$ | 최종 convolution feature 추출 및 공간 크기 축소 |
| Flatten | Input: $6 \times 6 \times 256$ 연산: Flatten Output: $9216$ | 3차원 feature map을 1차원 벡터로 변환 |
| FC1 | Input: $9216$ 연산: Fully Connected → ReLU → Dropout Output: $4096$ | 추출된 특징들을 종합 |
| FC2 | Input: $4096$ 연산: Fully Connected → ReLU → Dropout Output: $4096$ | 고수준 특징을 추가로 조합 |
| FC3 | Input: $4096$ 연산: Fully Connected Output: $1000$ logits | 1000개 클래스 각각에 대한 점수 계산 |
| Output | Input: $1000$ logits 연산: Softmax Output: $1000$ class probabilities | 각 클래스에 속할 확률 출력 |
Reducing Overfitting
Data Augmentation
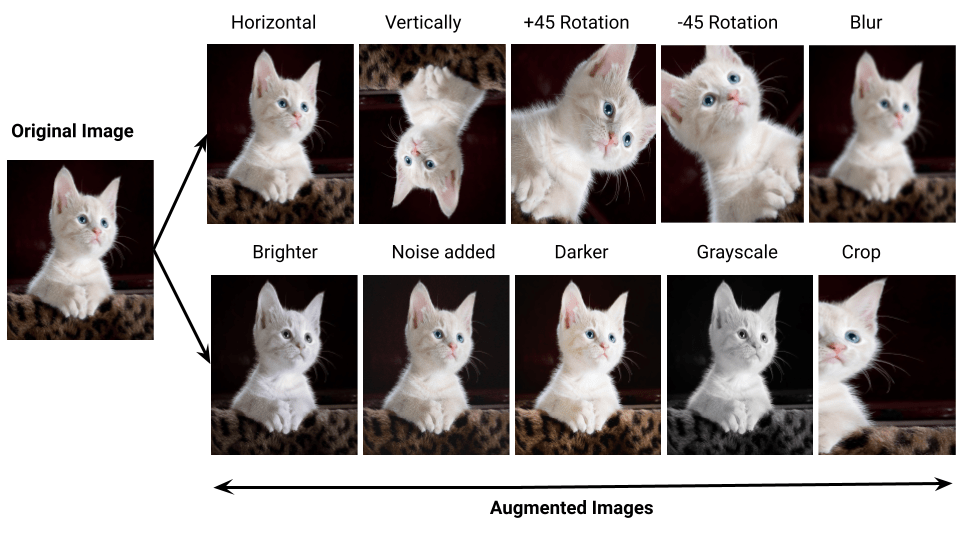
AlexNet에서는 오버피팅을 줄이기 위해 원래 이미지의 라벨이 변하지 않는 범위에서 데이터를 인위적으로 변형해 학습 데이터의 다양성을 늘렸다. 저자들은 크게 두 가지 데이터 증강 방법을 사용했는데, 하나는 이미지에서 임의의 영역을 잘라내거나 좌우 반전하는 방법이고(Random Crop + Horizontal Flip), 다른 하나는 RGB 채널의 밝기와 색상 값을 조금씩 변화시키는 방법이다.(RGB PCA) 이러한 변형은 계산량이 크지 않아 별도의 증강 이미지를 저장하지 않고 학습할 때마다 실시간으로 생성하여 사용할 수 있다.
즉 ImageNet Dataset을 기반으로 6천만개의 파라미터를 가진 모델을 학습시키게 되는데, 많은 파라미터에 비해서 데이터가 부족하여 과적합 위험이 큰 상황. 다양한 데이터 증강 기법 도입으로 데이터의 다양성과 일반화 능력을 확보하고자 함.
Image Size Transformation & Horizontal Flip
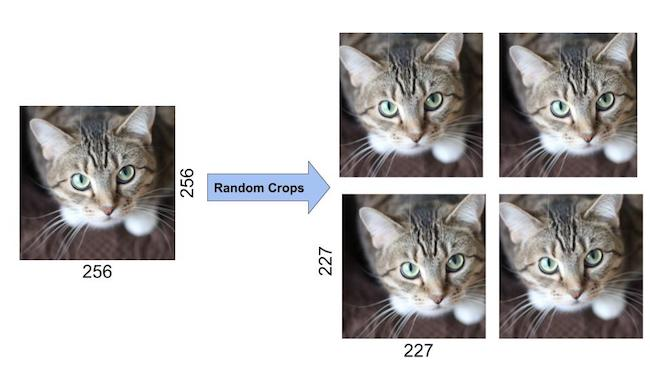
256 X 256 크기의 이미지에서 무작위로 224 X 224 크기의 패치를 추출 + 수평반전 을 적용함.
Training set 크기를 2048배 증가시켜 일반화 성능 향상을 도모하고자 함.
테스트 시에는 10개의 패치(5개 원본 + 5개 반전)의 평균 softmax로 최종 예측을 수행하였다.
모델이 위치와 방향 변화에 견고해짐.
RGB Channel Intensity Change
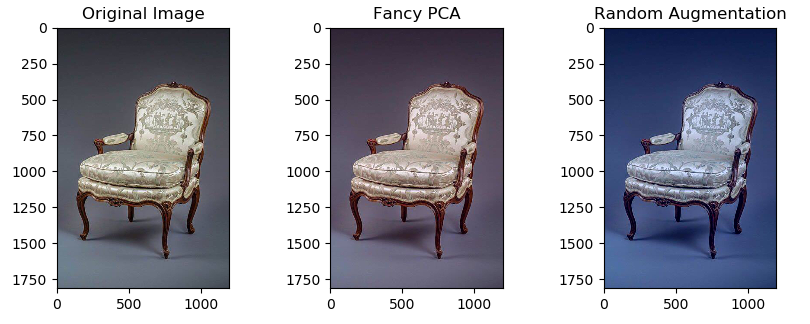
전체 Training set의 RGB 픽셀 값에 PCA를 적용함.
각 주성분 방향으로 평균 0, 표준편차 0.1를 갖는 가우시안 분포에서 랜덤 변수를 추출한 후, 해당 noise를 더해 밝기 변화 시뮬레이션을 적용함.
조명의 강도 및 색상 변화에 강건한 특성을 학습함.
이 augmentation만으로도 top-1 error가 1% 이상 감소했다고 보고한다.
Dropout
앙상블처럼 여러 모델의 예측을 결합하면 과적합 방지에는 효과적이지만, 훈련시간이 길고 비효율적임.
Dropout: 훈련 시 일부 뉴런을 무작위로 제거하여 간단하게 과적합을 줄이는 효과적인 기법으로, 약 2배의 계산 비용만으로 앙상블에 준하는 일반화 성능을 확보함.
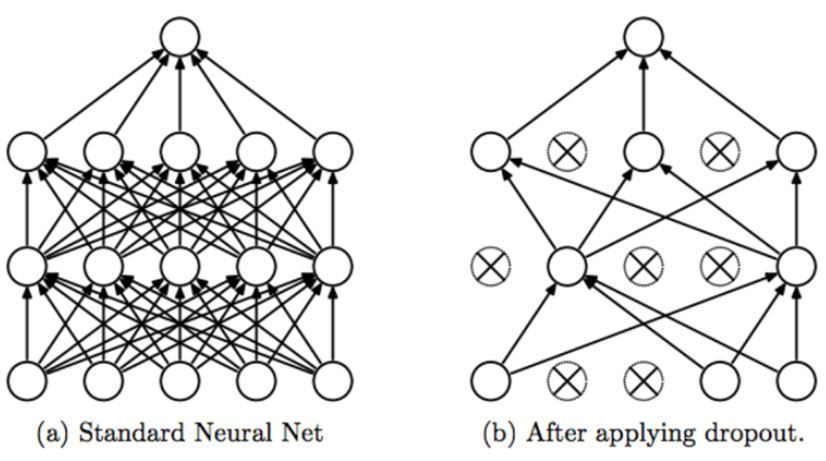
Droptout 기법은 사용자가 지정한 확률을 근거로 하여 특정 뉴런에 신호를 전달하지 않는 방법을 말하며, 이를 통해 모델의 복잡성을 크게 감소시키는 것이 가능함.
각 hidden layer 들의 출력을 50%의 확률로 0으로 설정함.
출력이 0이 된 뉴런들은 forward/backward에 참여하지 않음.
이는 다양한 서브 네트워크를 학습하는 것과 유사한 효과를 가짐.
Dropout은 다른 뉴런들에게 의존할 수 없게 하여 co-adaptations 을 줄임.
즉, 다른 하위 집합의 뉴런들과 같이 robust한 특징을 학습하도록 함.
테스트 시에는 모든 뉴런을 사용하되, 학습 시 제거된 확률 (0.5) 을 보정 계수로 곱함.