[Paper] Vision Transformer: An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale
1. Abstract
이미지를 고정 크기의 patch로 나누고, 각 patch를 token처럼 취급하여 standard Transformer를 이미지 분류에 직접 적용함.
ViT는 중간 규모의 데이터에서는 CNN보다 성능이 떨어질 수 있지만, 대규모 데이터셋으로 pre-training한 뒤 downstream task에 transfer하면 기존 CNN 기반 모델과 경쟁하거나 더 좋은 성능을 보임.
핵심적으로 CNN 없이도 Transformer만으로 image recognition이 가능하며, 데이터와 모델 규모가 커질수록 좋은 scalability를 보임.
2. Introduction
Transformer는 NLP에서 대규모 pre-training과 transfer learning을 통해 큰 성공을 거두었고, 이를 Vision에도 적용할 수 있는지 확인하고자 함.
기존 Vision 모델은 주로 CNN에 의존했지만, ViT는 이미지를 patch sequence로 변환하여 Transformer Encoder에 거의 그대로 입력함.
CNN에 비해 image-specific inductive bias가 적기 때문에 작은 데이터에서는 불리하지만, 충분히 큰 데이터로 학습하면 이러한 한계를 극복하고 강력한 representation learning 능력을 보임.
3. Method
3.1 Vision Transformer (ViT)
(필기로 대체함)
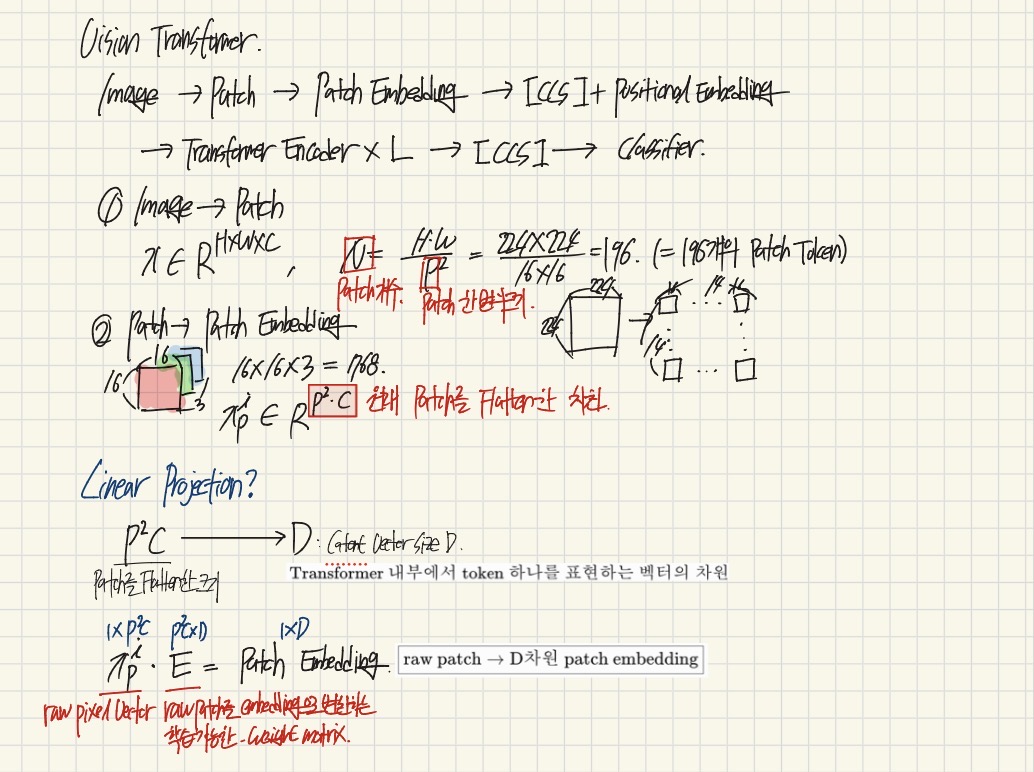
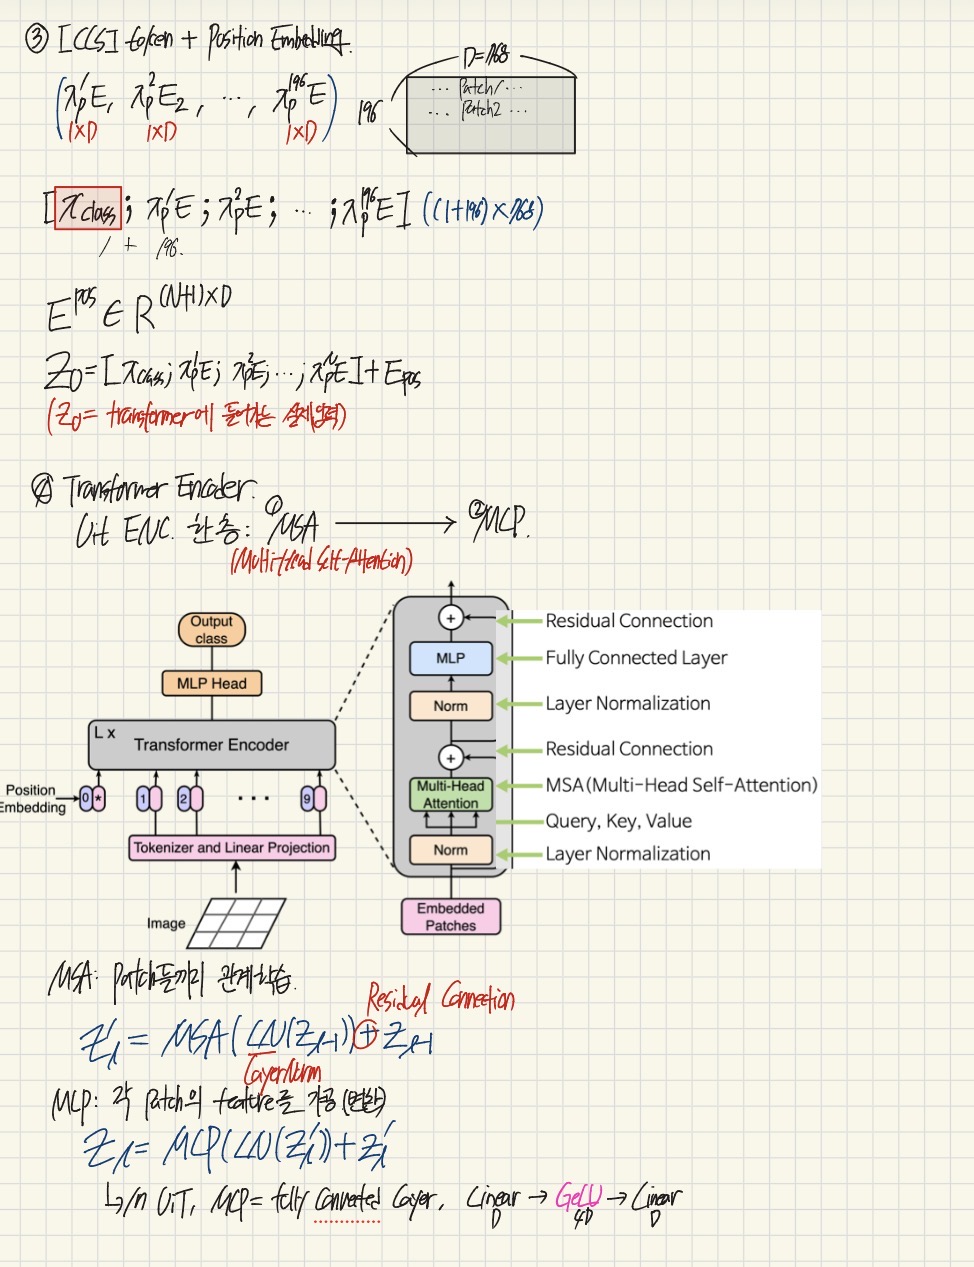
Inductive bias.
핵심: CNN은 이미지의 2차원 구조를 구조적으로 알고 시작하지만, ViT는 거의 모른 채 시작한다 (CNN은 convolution 때문에 애초에 “가까이 붙어있는 픽셀 및 특징끼리 먼저 보자” 라는 구조가 강제로 내장되어 있음. 반면 ViT의 self-attention 은 처음부터 모든 patch를 서로 볼 수 있음.)
1
2
3
- 가까운 픽셀/patch끼리 연관이 크다 → locality
- 이미지가 2D 격자 구조다 → 2D neighborhood
- 물체가 조금 이동해도 같은 특징으로 본다 → translation equivariance
논문에서는 CNN은 locality, two-dimensional neighborhood structure, translation equivariance 와 같은 inductive bias를 가지고 있지만,
ViT는 MLP layers 에서만 국소적이고 translationally equivariant함 + self-attention 에서는 Global 함을 언급함.
2D neighborhood는 1. 모델의 시작부분 에서 이미지 patch를 나눌 때 2. fine-tuning 과정에서 서로 다른 해상도의 이미지에 맞게 position embedding을 조정할 때만 사용됨.
1
2
3
4
5
6
7
처음 patch를 자를 때
- 이미지를 16×16 같은 2D 블록으로 나눔
- 여기서만 이미지가 2차원 격자라는 사실을 직접 사용함

fine-tuning 때 해상도가 바뀌면 position embedding을 2D interpolation할 때
- 예: 224×224로 pretrain → 384×384로 fine-tuning
- patch 개수가 달라지니까 기존 position embedding을 2D 격자 기준으로 늘려 맞춤
Hybrid Architecture.
raw image를 바로 patch로 만드는 대신 CNN feature map을 token으로 만들어 Transformer에 넣는 방식을 사용할 수 있음을 언급함.
3.2 Fine-Tuning and Higher Resolution
pre-train은 large datasets으로 하였고, fine-tune은 더 작은 downstream tasks로 진행함.
pre-train 때 사용했던 prediction head를 제거하고, 0으로 초기화된 D x K 크기의 feedforward layer를 새로 붙임. (K=downstream task의 class 개수)
fine-tuning 에서는 더 높은 해상도의 이미지를 입력하게 되는데, 이때 patch size는 그대로 유지됨 \(\rightarrow\) 이미지 안의 patch 개수가 늘어남 \(\rightarrow\) pre-training 때 학습했던 PE이 더 이상 새로운 해상도에 적절하지 않을 수 있음 \(\rightarrow\) 따라서 원본 이미지에서 각 patch가 있던 위치를 기준으로 사전학습된 position embedding에 2D interpolation을 수행함.
❓Prediction head: 모델이 만든 feature를 최종 class 점수로 바꾸는 마지막 분류층.
\[\text{[CLS]\ feature}\;(D) \rightarrow \mathrm{Linear}(D \rightarrow K) \rightarrow K\ \mathrm{class\ scores}\]4. Experiments
ResNet, Vision Transformer(ViT), 그리고 hybrid 모델의 representation learning 능력을 평가함. 각 모델이 어느 정도의 데이터를 필요로 하는지 이해하기 위해 서로 다른 크기의 데이터셋으로 사전학습한 뒤 다양한 benchmark task에서 평가했다고 밝힘.
사전학습 계산 비용 고려 시 매우 좋은 성능을 보였고, 더 낮은 사전학습 비용으로 대부분의 recognition benchmark 에서 SOTA.
마지막으로 self-supervision 을 이용한 작은 실험을 수행하여, 이 역시도 향후 발전 가능성이 있음을 시사함. (원래는 human supervision supervised learning)
❓self-supervision: 사람이 정답 라벨을 직접 붙여주지 않아도, 데이터 자체에서 학습용 정답을 만들어서 학습하는 방식.
4.1 Setup
Datasets
Pre-training용
ILSVRC-2012 ImageNet: 1,000개 class, 130만 장 (개, 고양이, 자동차, 음식, 생활용품 등 일반적인 객체 이미지)
ImageNet-21k: 21,000개 class, 1,400만 장 (ImageNet-1k를 훨씬 확장한 데이터. 훨씬 다양한 사물·동물·개념 포함)
JFT: 18,000개 class, 3억 300만 장의 고해상도 이미지 (Google이 구축한 초대규모 이미지 데이터셋. 다양한 실제 이미지와 다중 라벨 포함)
Transfer용
ImageNet (동물, 사물 등 일반 이미지)
ImageNet-ReaL (ImageNet validation set의 라벨을 더 정확하게 재검토한 버전)
CIFAR-10/100 (\(32\times32\) 저해상도 이미지. 자동차, 개, 고양이 등, CIFAR-10보다 세분화된 100종류 분류)
Oxford-IIIT Pets (개·고양이 품종 분류)
Oxford Flowers-102 (꽃 종류 분류)
등의 benchmark task로 transfer함.
pre-training data를 점점 크게 만들었을 때 ViT의 성능이 어떻게 scailing 되는가를 보고자 함. (모델 크기나 연산량을 키웠을 때 성능이 얼마나 잘 따라 올라가는지 보고자)
❓de-duplicate: downstream test image가 pre-training dataset에 우연히 들어가 있는 것을 제거한다는 뜻
또한 19개의 task로 구성된 VTAB classification suite에서도 모델을 평가. VTAB은 각 task마다 단 1,000개의 training example만 사용하며, 적은 데이터 환경에서 다양한 task로 transfer 하는 능력을 평가함. (적은 데이터만 가지고 새로운 문제에 얼마나 잘 적응하냐를 평가하는 benchmark임)
1
2
3
4
5
6
7
8
Natural
Pets, CIFAR 등 일반적인 자연 이미지 관련 task

Specialized
의료 영상이나 위성 영상처럼 특정 분야에 특화된 이미지 task

Structured
localization처럼 이미지의 위치나 기하학적 구조를 이해해야 하는 task
Model Variants
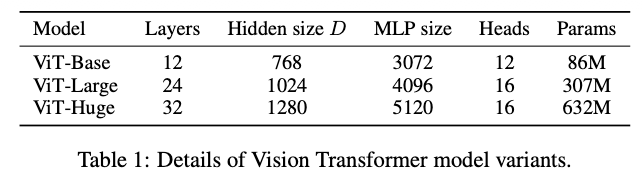
ViT configuration은 BERT에서 사용된 모델 configuration을 기반으로 함.
Vit-Base,Large 는 BERT의 모델 크기를 직접 가져옴. 거기에 더 큰 Huge 모델을 추가함.
Baseline 으로는 CNN을 사용하고 ResNet을 사용하지만, Batch Normalization layers를 Group Normalization으로 대체하고 standardized convolution (=convolution filter의 weight를 표준화한 뒤 convolution을 수행하는 방식을 말함)을 사용함. transfer learning 성능을 향상시키는 변경임.
Hybrid 모델에서는 CNN의 intermediate feature map을 ViT에 입력하고, 이때 CNN feature map에서 하나의 pixel을 하나의 patch처럼 취급함.
Training & Fine-tuning
In Pre-training,
모든 모델을 Adam optimizer로 학습하였음.
(세부 hyperparameter 설정은 작성 생략)
Learning Rate Linear Warmup 과 Learning Rate decay를 사용함. (learning rate는 한번 업데이트 할 때 얼마나 크게 움직일지 정하는지의 개념으로서, 초반에는 LR을 선형적으로 올리고, 이후에는 선형적으로 줄였다.)
❓Adam: gradient의 방향과 크기를 함께 추적하면서 각 parameter의 learning rate를 자동 조절.
❓Weight decay: 모델이 학습하면서 weight 값이 지나치게 커지는 것을 억제하는 regularization
\(L_{\text{total}} = L(w) + \lambda \|w\|^2\)
에서 \(\lambda\) 에 해당하는 개념.
In Fine-tuning,
SGD with momentum optimizer를 사용함. batch size = 512.
Fine-tuning 시에는, pre-training 때보다 더 큰 크기의 이미지를 넣어서 fine-tuning 함.
예를 들어, ViT-L/16 에서는 Pre-training: 224 x 224 \(\rightarrow\) Fine-tuning: 512 x 512 로 입력 이미지의 해상도를 높임.
❓SGD+Momentum VS. Adam(헷갈렸던 부분)
SGD + Momentum: 과거 gradient의 방향을 누적해서 관성 있게 이동한다.
Adam: 방향도 누적하면서, gradient의 크기까지 추적해서 각 parameter
Metrics
Downstream dataset 에서의 성능은 두 가지 방식으로 평가함.
Fine-tuning accuracy (주요 metric, 최종성능비교)
→ downstream dataset에서 모델 전체를 fine-tuning한 뒤 분류 정확도(accuracy) 측정.
Linear few-shot accuracy (보조 metric, 실험 도중 수많은 모델을 빠르게 비교)
→ ViT는 freeze하고, 적은 데이터로 linear classifier만 학습한 뒤 분류 정확도 측정.
Few-shot accuracies are obtained by solving a regularized least-squares regression problem
that maps the (frozen) representation of a subset of training images to \(\{−1,1\}^K\) target vectors. (Few-shot accuracy는 training image의 일부에서 얻은 고정된(frozen) representation을 \(\{−1,1\}^K\) 형태의 target vector로 매핑하는 regularized least-squares regression(정규화된 최소제곱 회귀) 문제를 풀어 계산한다.)
\(\rightarrow\) 제일 이해하기 어려웠던 표현. ViT가 이미 학습한 feature가 얼마나 좋은지, ViT 자체는 건드리지 않고 간단한 분류기만 붙여서 테스트한다 라는 뜻.
예를 들어 고양이/개/자동차 3개 class가 있다고 하자.
- ViT를 freeze함.
(이미지를 pretrained ViT에 넣으면 represenation (e.g.) \(z\) = [0.2, 1.3, -0.7, … ])이 나오고, 여기서 ViT의 parameter는 update 하지 않음.) - 정답을 \(\{−1,1\}^K\) 로 만든다.
class가 3개라고 한다면, K = 3
고양이가 1번 class: y = [1, -1, -1]
개라면 : y = [-1, 1, -1]
자동차라면 : y = [-1, -1, 1]
즉, 정답 class만 1, 나머지는 -1로 표현함. - \(z\) 에서 \(y\) 를 맞히는 간단한 선형식을 찾는다.
ViT가 뽑은 representation z에 어떤 행렬 W를 곱해서
\(zW\approx y\) 가 되게 만들고 싶은 것.
이 \(W\)를 찾는 방법으로 regularized least-squares regression을 사용함.
저자들은 fine-tuning 성능에 초점을 맞추지만, fine-tuning을 수행하기에는 비용이 너무 큰 경우 빠르게 성능을 평가하기 위해 linear few-shot accuracy를 사용하기도 한다 라고 언급함.
4.2 Comparison To SOTA
ViT-H/14, ViT-L/16을 기존 연구에서 보고된 SOTA CNN 모델들과 비교함.
- Big Transfer(BiT) - 큰 규모의 ResNet을 이용해 supervised transfer learning을 수행하는 모델 (ImageNet을 제외한 본문의 다른 datasets 에서 SOTA)
- Noisy Student - 대규모 EfficientNet 모델로, ImageNet과 label을 제거한 JFT-300M을 이용하여 semi-supervised learning 방식으로 학습됨. (당시, ImageNet 에서 SOTA)
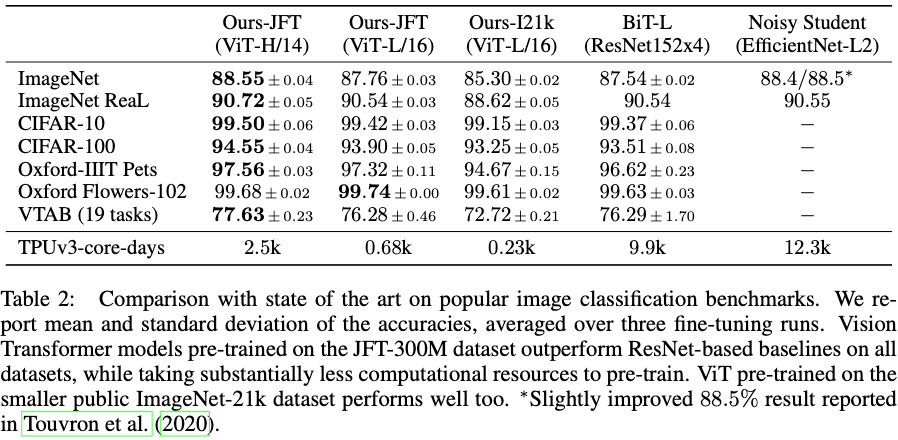
JFT-300M으로 사전학습된 ViT16-L/16 모델이 동일한 dataset으로 사전학습된 BiT-L에 비해서 모든 task에서 더 높은 성능을 보이면서도, 학습에서 훨씬 적은 computational resorurce를 필요로 했음.
더 큰 모델인 ViT-H/14는 성능을 더욱 향상시켰으며, 특히 ImageNet, CIFAR-100, VTAB suite와 같이 더 어려운 dataset에서 성능 향상이 두드러짐.
저자들은 pre-training efficiency가 단순히 아키텍처 선택에 의해서만 결정되는 거싱 아니라, training schedule, optimizer, weight decay 등의 다른 parameter에 의해서도 영향을 받을 수 있다는점을 지적함. (Section 4.4에서 서로 다른 architecture에 대해 performance와 compute의 관계를 통제된 조건에서 비교하는 실험을 제공함.)
ImageNet-21k로 pre-training한 ViT-L/16도 좋은 성능을 보임. (pre-training에 필요한 resource가 적었고, 30일 정도에 학습함)
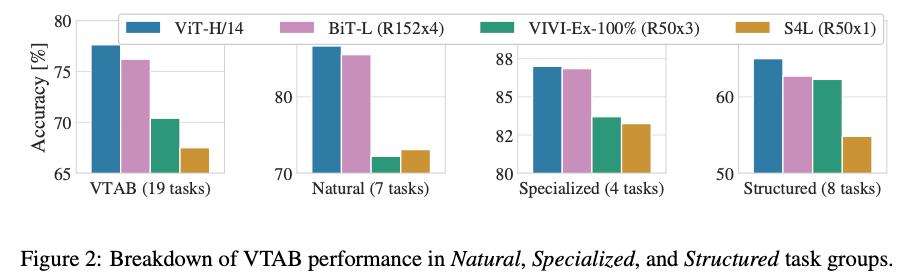
Figure 2: VTAB 성능을 Natural, Specialized, Structured task group별로 나누어 분석한 결과.
1
2
3
Natural: 일반적인 자연 이미지
Specialized: 의료/위성 같은 특수 domain
Structured: 위치, 거리, 방향 등 공간적 구조를 이해해야 하는 task
VIVI: ImageNet과 YouTube 데이터로 함께 학습한 ResNet 기반 방법의 이름
S4L: ImageNet에서 supervised learning과 semi-supervised learning을 함께 사용하는 방법의 이름
ViT-H/14가 특히 Natural과 Structured에서 강하고, Specialized에서는 BiT와 거의 비슷함
4.3 Pre-training Data Requirements
Vision Transformer는 대규모 JFT-300M dataset으로 pre-training했을 때 좋은 성능을 보임.
그런데 ViT는 ResNet보다 vision에 대한 inductive bias가 적은데, 그렇다면 dataset의 크기는 얼마나 중요한가? 를 보기 위해 2가지 실험을 수행함.
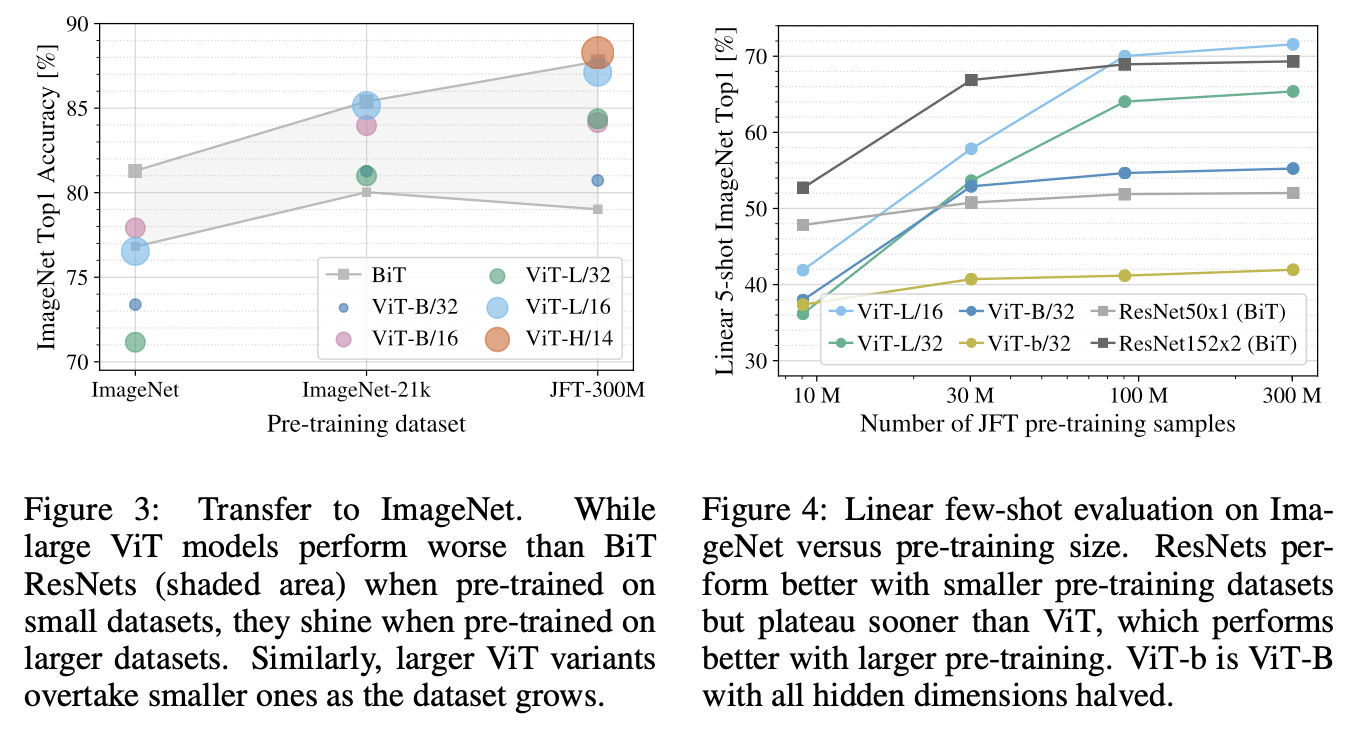
| Figure 3 | Figure 4 | |
|---|---|---|
| 실험 | 서로 다른 규모의 3개 데이터셋으로 pre-training | JFT 하나에서 데이터 개수만 바꿔 pre-training |
| Pre-training 데이터 | ImageNet 1.3M → ImageNet-21k 14M → JFT-300M | JFT 9M → 30M → 90M → 300M |
| Hyperparameter | 작은 데이터에 맞게 regularization도 각각 튜닝 | 모두 동일하게 고정 |
| 평가 | ImageNet으로 fine-tuning 후 Top-1 accuracy | 모델 freeze 후 ImageNet linear 5-shot accuracy |
| 알고 싶은 것 | 큰 ViT가 언제 작은 ViT보다 좋아지는가? | 다른 조건을 고정하고 데이터 양만 늘리면 ViT와 ResNet이 어떻게 달라지는가? |
Figure3
ImageNet으로의 transfer 결과. (모델 크기와 dataset 규모의 관계는?)
데이터셋 규모가 커질수록 큰 ViT의 장점이 나타나는지 확인한 실험.
⭐️JFT-300M 정도의 대규모 dataset을 사용했을 때에야 비로소 더 큰 모델의 장점을 완전히 확인할 수 있다.
Figure4
Pre-training dataset 크기에 따른 ImageNet linear few-shot evaluation.
같은 JFT에서 데이터 개수만 늘려서, ViT와 ResNet 중 누가 데이터 증가의 이득을 더 많이 받는지 확인한 통제 실험.
⭐️ViT는 더 큰 규모로 pre-training할수록 더 높은 성능을 보임.
ResNet은 pre-training dataset이 작을 때 더 좋은 성능을 보이지만, ViT보다 더 빨리 성능 향상이 정체된다.
다른 조건을 고정하고 데이터 양만 늘리면 ViT와 ResNet이 어떻게 달라지는가? 를 보는 실험.
(9M, 30M, 90M, 300M 으로 데이터 양만 바꾸고, weight decay나 dropout 같은 hyperparameter는 똑같이 둠)
❓Linear 5-shot ImageNet Top-1 Accuracy: ImageNet 각 클래스당 5장만 써서 frozen ViT feature 위에 linear classifier를 맞춘 뒤, ImageNet 검증 이미지들을 분류했을 때 1순위 예측이 정답인 비율을 재는 것.
즉, ViT를 fine-tuning한 게 아닌, ViT 본체는 그대로 고정하고:
\(\text{Frozen ViT} \rightarrow \text{Linear classifier만 맞춤}\)
먼저 ViT 모델들을 점점 더 큰 dataset인 ImageNet → ImageNet-21k → JFT-300M에서 pre-training.
작은 dataset에서의 성능을 높이기 위해 세 가지 기본적인 regularization parameter인 weight decay, dropout, label smoothing을 최적화.
- Weight decay: weight가 지나치게 커지는 것을 억제
- Dropout: 학습 중 일부 neuron을 무작위로 끔
- Label smoothing: 정답을 무조건 \(1\), 나머지를 \(0\)으로 두지 않고 조금 부드럽게 만듦 (예를 들어 일반적인 one-hot label이 \([1,0,0,0]\) 이라면 label smoothing을 적용해서 대략 \([0.9,0.033,0.033,0.033]\))
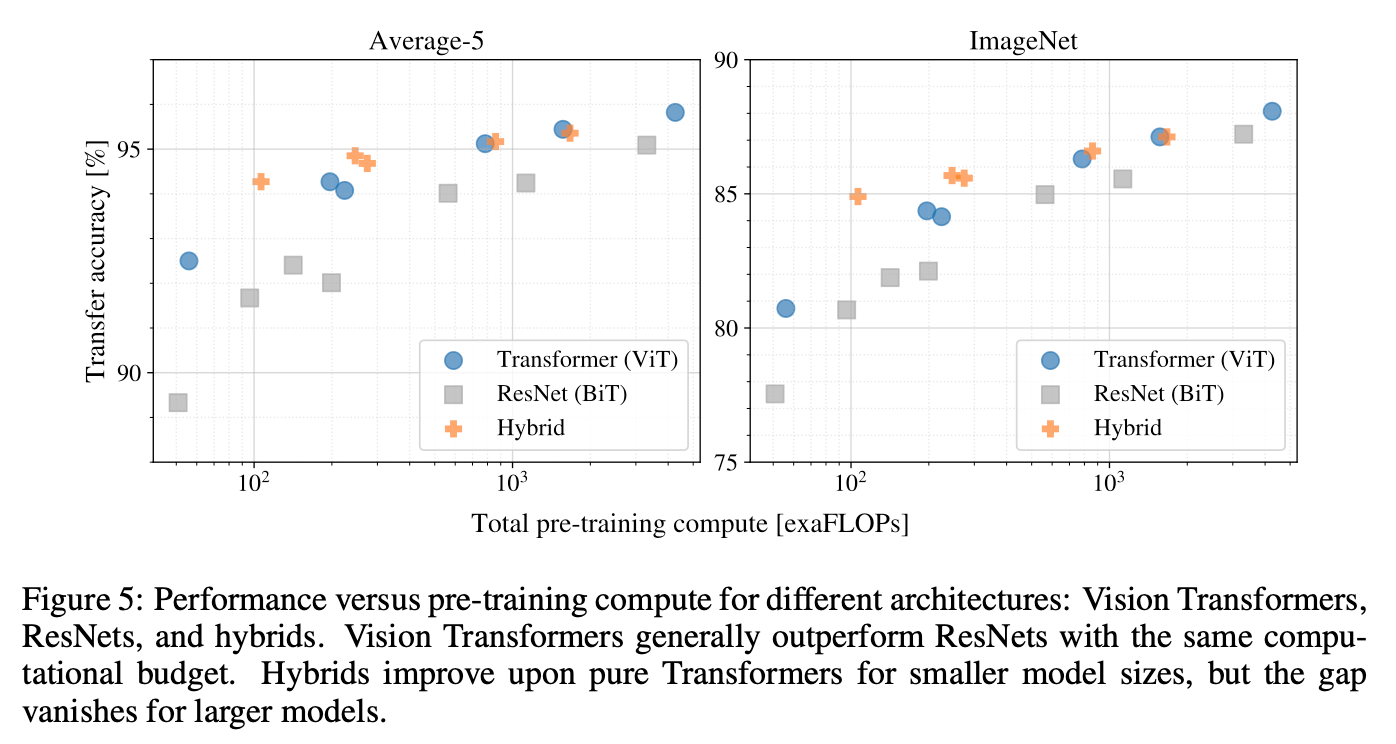
4.4 Scailing Study
Figure 5: 서로 다른 architecture인 Vision Transformer, ResNet, 그리고 hybrid 모델에 대해 pre-training에 사용한 연산량과 성능 사이의 관계를 나타냄.
Vision Transformer는 일반적으로 동일한 computational budget(연산량)을 사용했을 때 ResNet보다 더 높은 성능을 보임.
- 같은 성능을 내는 데 ViT가 ResNet보다 약 2~4배 적은 compute를 사용했다.
- 작은 모델에서는 Hybrid가 ViT보다 약간 좋지만, 모델이 커지면 차이가 사라졌다.
- ViT는 실험 범위에서 아직 saturation되지 않아, 더 크게 학습할수록 성능이 더 오를 가능성을 보였다.
4.5 Inspecting Vision Transformer
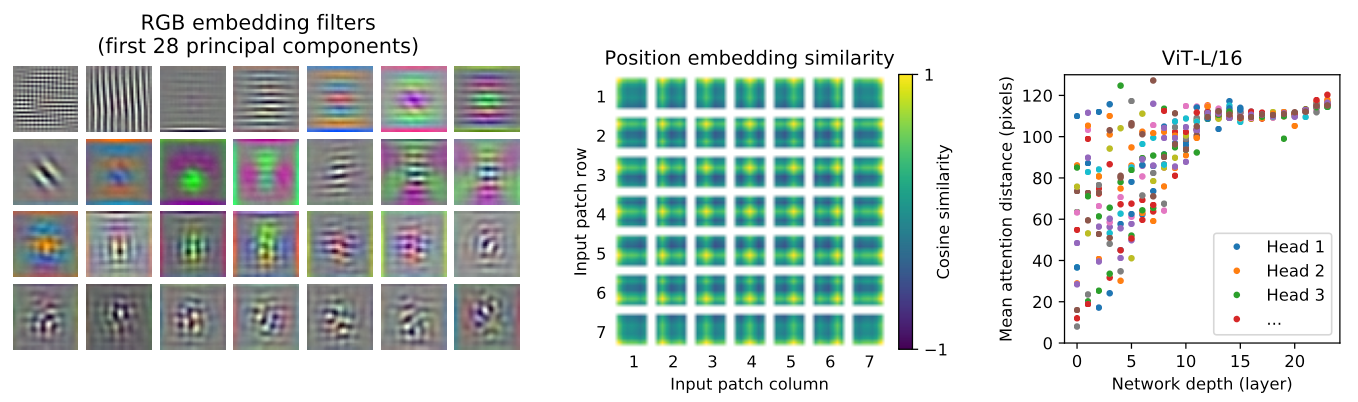
| 분석 대상 | 저자들이 알고 싶은 것 | 결과 |
|---|---|---|
| Patch Embedding | patch를 처음 변환하는 linear layer가 무슨 시각적 특징을 학습했나? | edge, 색 변화 같은 low-level visual pattern을 잡는 filter 비슷한 것을 학습 |
| Position Embedding | ViT가 patch들의 2D 위치 관계를 이해하고 있나? | 가까운 patch, 같은 row/column 등의 2D 구조를 스스로 학습 |
| Self-Attention | 각 layer에서 어디까지 정보를 보고 섞는가? | 초기부터 local하게 보는 head와 global하게 보는 head가 모두 존재 |
Patch Embedding
ViT에서는 \(16\times16\times3\) patch를 펼친 다음:
\(x_p \in \mathbb{R}^{16 \times 16 \times 3} = \mathbb{R}^{768}\)
linear projection을 해서 \(D\)차원 embedding으로 만듦.
\(z = x_p E\)
“이 linear projection이 도대체 뭘 학습했나?”를 보고자 하였고, 그 결과 edge, 색 변화, 방향 같은 low-level image pattern을 잡아내는 CNN filter 비슷한 구조를 학습함.
Position Embedding
Projection 이후에는 학습된 position embedding이 patch representation에 더해짐.
- 모델이 position embedding들의 유사도를 통해 이미지 내부의 거리 정보를 학습.
- row-column 구조도 나타냄. (같은 행이나 같은 열에 있는 patch들이 서로 비슷한 embedding을 가짐)
- 더 큰 grid에서는 sinusoidal한 구조가 나타나는 경우도 있다. (position embedding이 2차원 이미지의 topology를 스스로 학습하여 표현)
Self-Attention
분석 결과, 일부 attention head는 가장 낮은 layer에서부터 이미 이미지의 대부분 영역에 attention을 주고 있었다. 이는 모델이 실제로 global information을 통합하는 능력을 사용하고 있음을 보임.
ViT는 초기 layer부터 global 정보를 볼 수 있다.
어떤 attention head는 첫 layer부터 이미지의 멀리 떨어진 patch들까지 본다.동시에 local attention도 존재한다.
어떤 head는 가까운 patch 위주로 본다. 이건 CNN의 초기 convolution이 local feature를 보는 것과 비슷한 역할을 한다.