[Paper] You Only Look Once: Unified, Real-Time Object Detection
(Background) What is Object Detection?
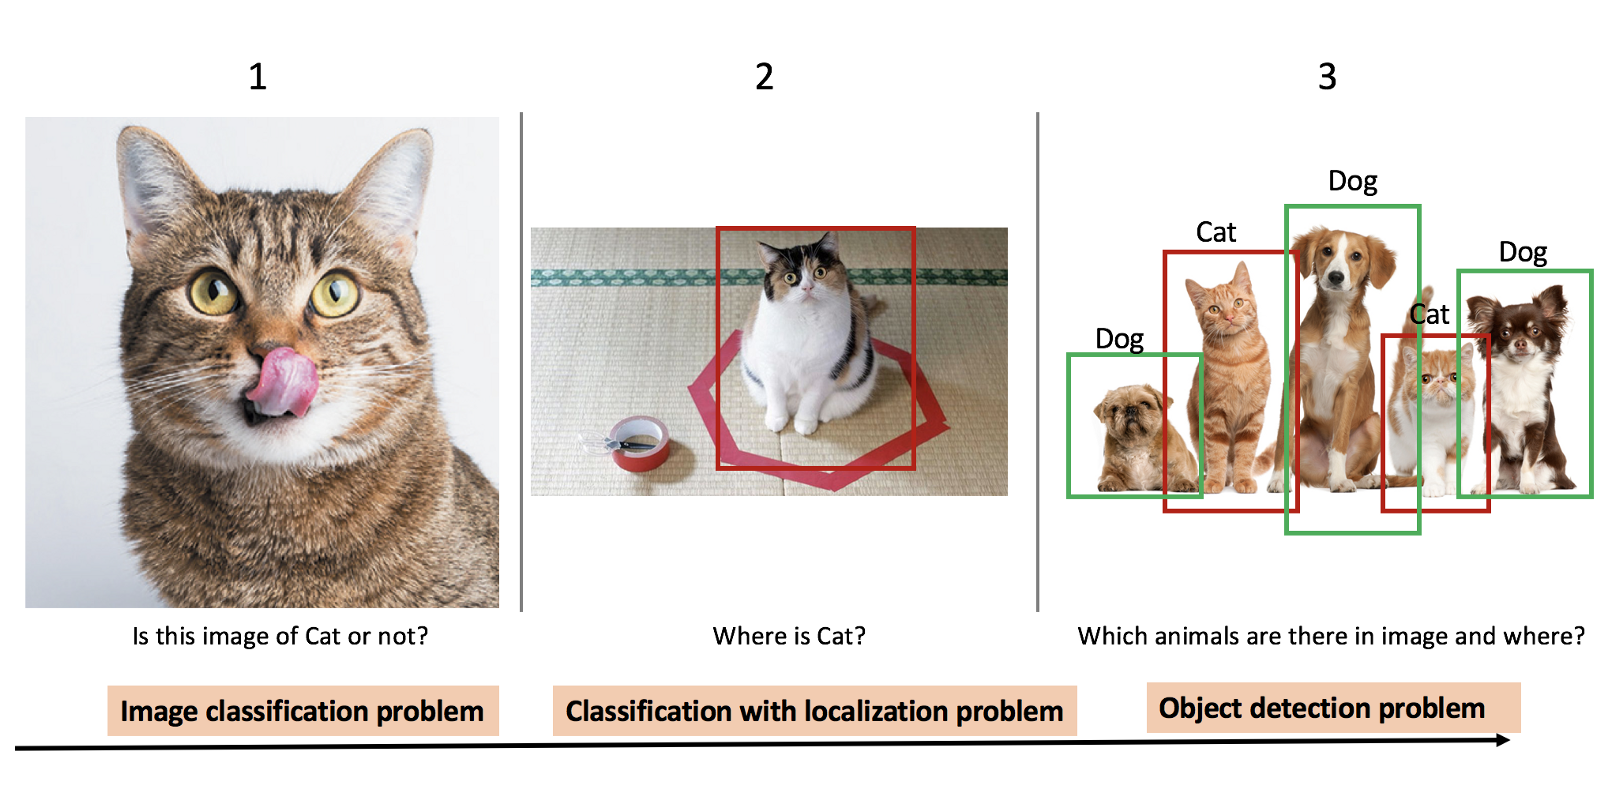
object classifcation: 이미지 내 single object, output: class probability (Object class)
object localization: 이미지 내 single object, output: (x,y,w,h) (Object Class, Bounding Box: 물체의 위치)
object detection: 이미지 내 multiple object, output: class probabilities + (x,y,w,h) (Objet class, Bounding Box)
(Background) One-Stage Detector VS. Two-Stage Detector
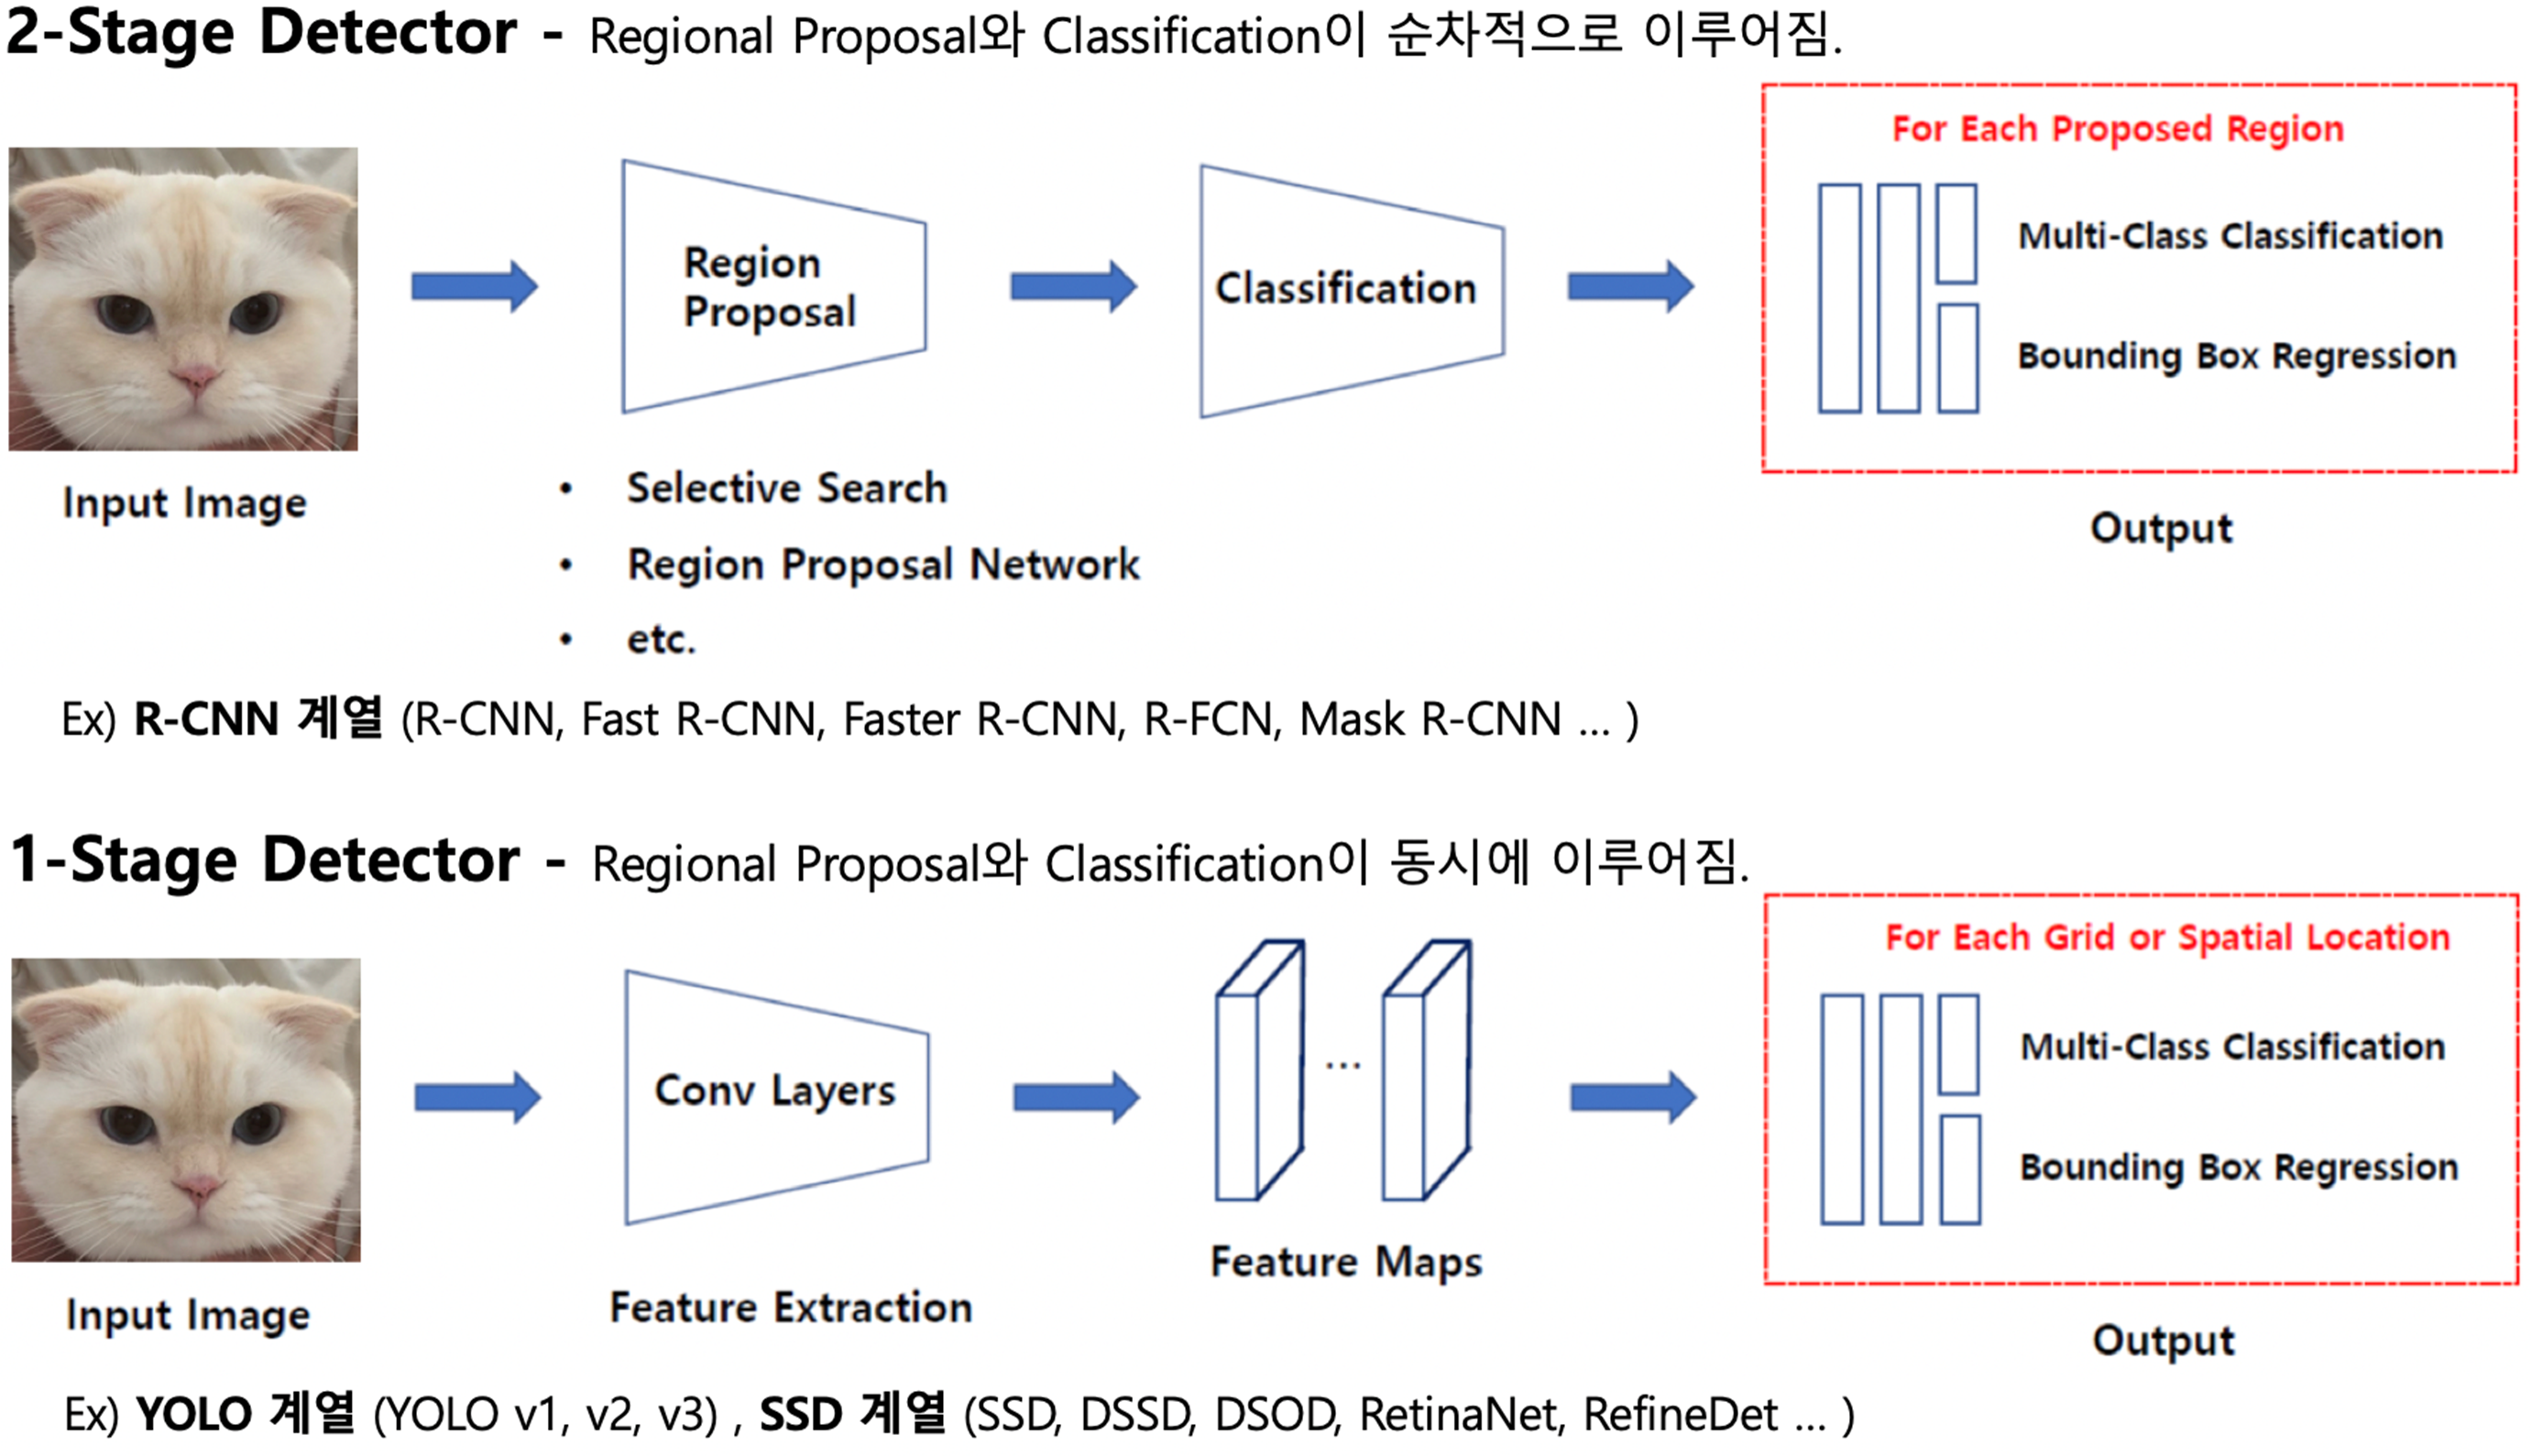
One-Stage Detector
localization 과 classifcation 동시에 수행하여 결과를 얻는 방식
한번의 network forward 에서 image → Bounding Box + Object Class + Confidence 를 바로 예측.
즉, “여기에 사람이 있고, box는 이 좌표다”
(별도로 물체가 있을 법한 영역(잠재영역)을 먼저 찾지 않음)
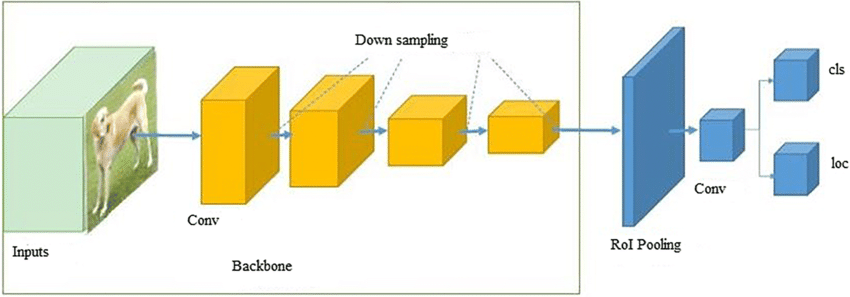
Conv & FC layers 를 거친 후 output 를 reshape 하여 output tensor를 만들어냄. 그 후 알고리즘을 적용하여 classifcation 과 bounding box 의 위치까지 찾아냄.
Two-Stage Detector
Localization → Clasification 순차적으로 수행하여 결과 얻음. (Faster R-CNN이 대표적인 예시임)
첫번째로 물체가 있을 것 같은 후보 영역인 Regional Proposal을 만듦.
두번째로 그 결과를 받아 각각을 자세히 보면서, Object Class를 예측함. (Classification)
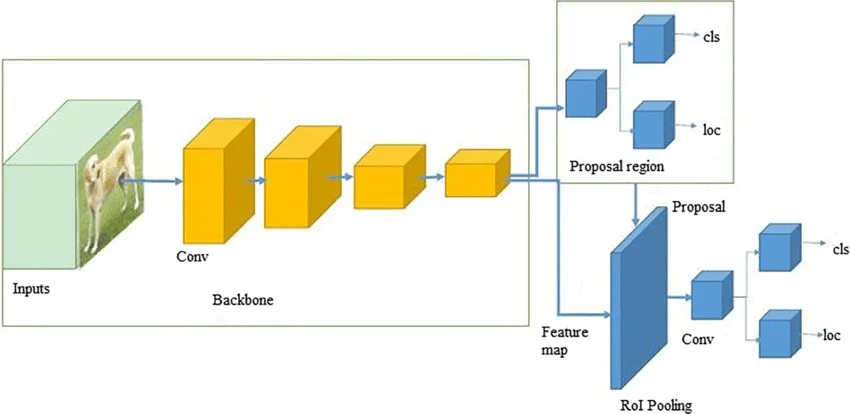
먼저 원본 이미지 전체를 Backbone CNN에 넣어 Feature Map을 생성한다.
RPN(region proposal network) 에서의 첫번째 stage에서 proposed regions(물체가 있음직한 영역)를 찾아낸다. Output: Proposal1 = [x1, y1, x2, y2] 와 같은 Proposal Regions, ROI
두번째 stage 에서는 stage1에서 찾은 Proposal 위치를 Feature Map 위에 대응시킨다. 아까 찾아낸 proposed regions를 적절히 비율을 맞춰 투영시켜 해당 결과값을 RoI Align으로 일정한 크기로 맞춰 FC Layers에 전달하고 Classifcation 과 Box Refinement(처음 Proposal의 박스 위치를 더 정확하게 수정) 를 가능하게 함.
You Only Look Once: Unified, Real-Time Object Detection
Unified, Real-Time Object Detection
You Only Look Once: 전체 이미지 보는 횟수 1회
Unified: classification & Localization 단계 단일화
Real-Time: 속도 개선
Main Contribution
1) Object detection 을 regression problem 으로 관점 전환
2) Unified Architecture: 하나의 신경망으로 classification & Localization 예측
3) Fast Detection: 속도 개선
4) Generalization: 여러 도메인에서 object detection 가능
2. Unified Detection
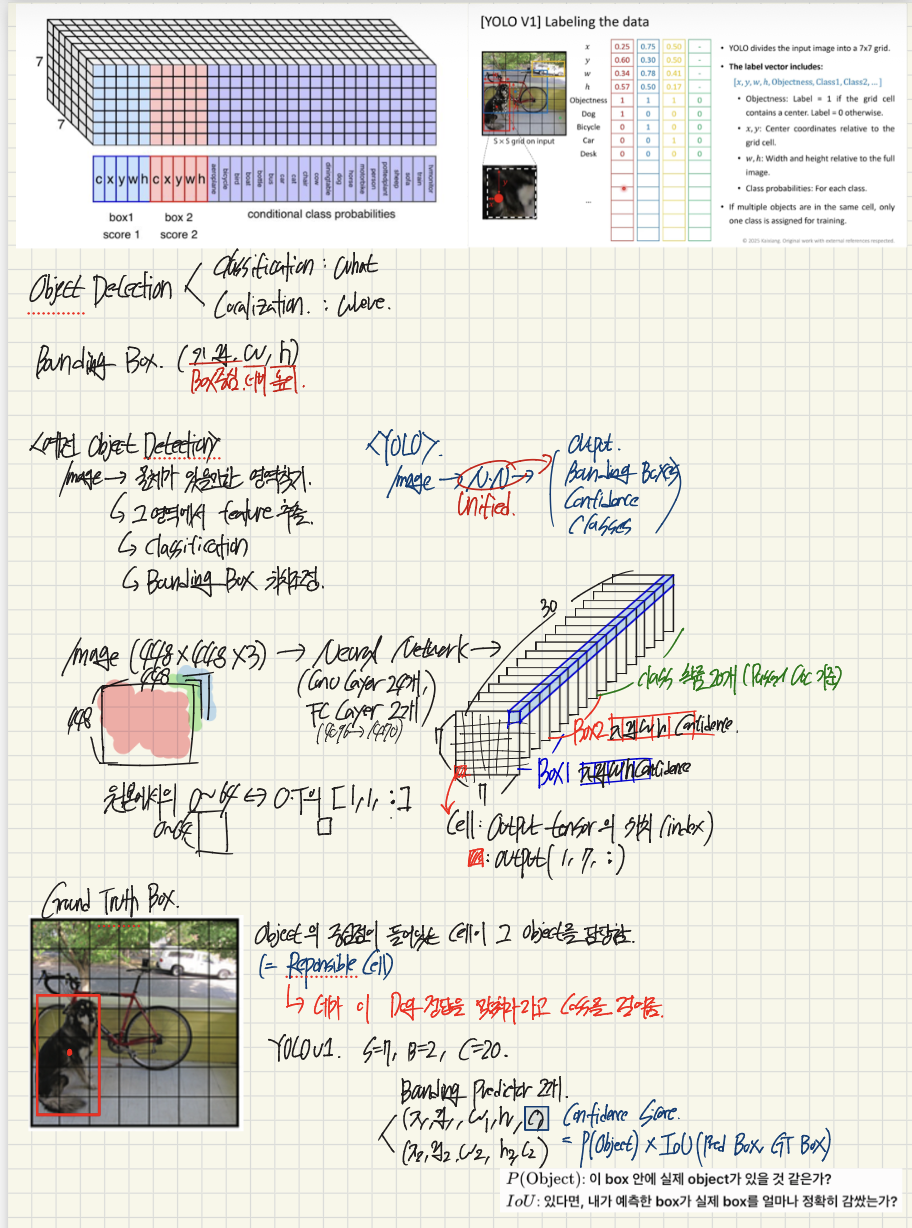
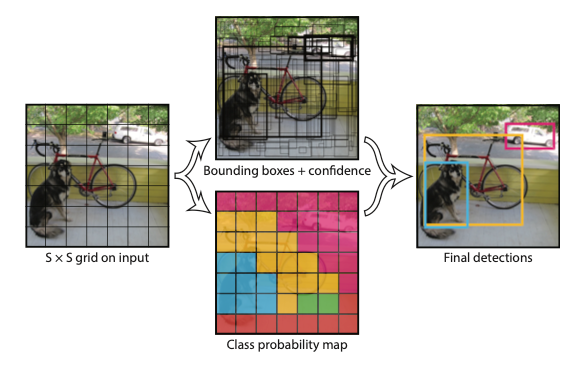
2.1 Network Design
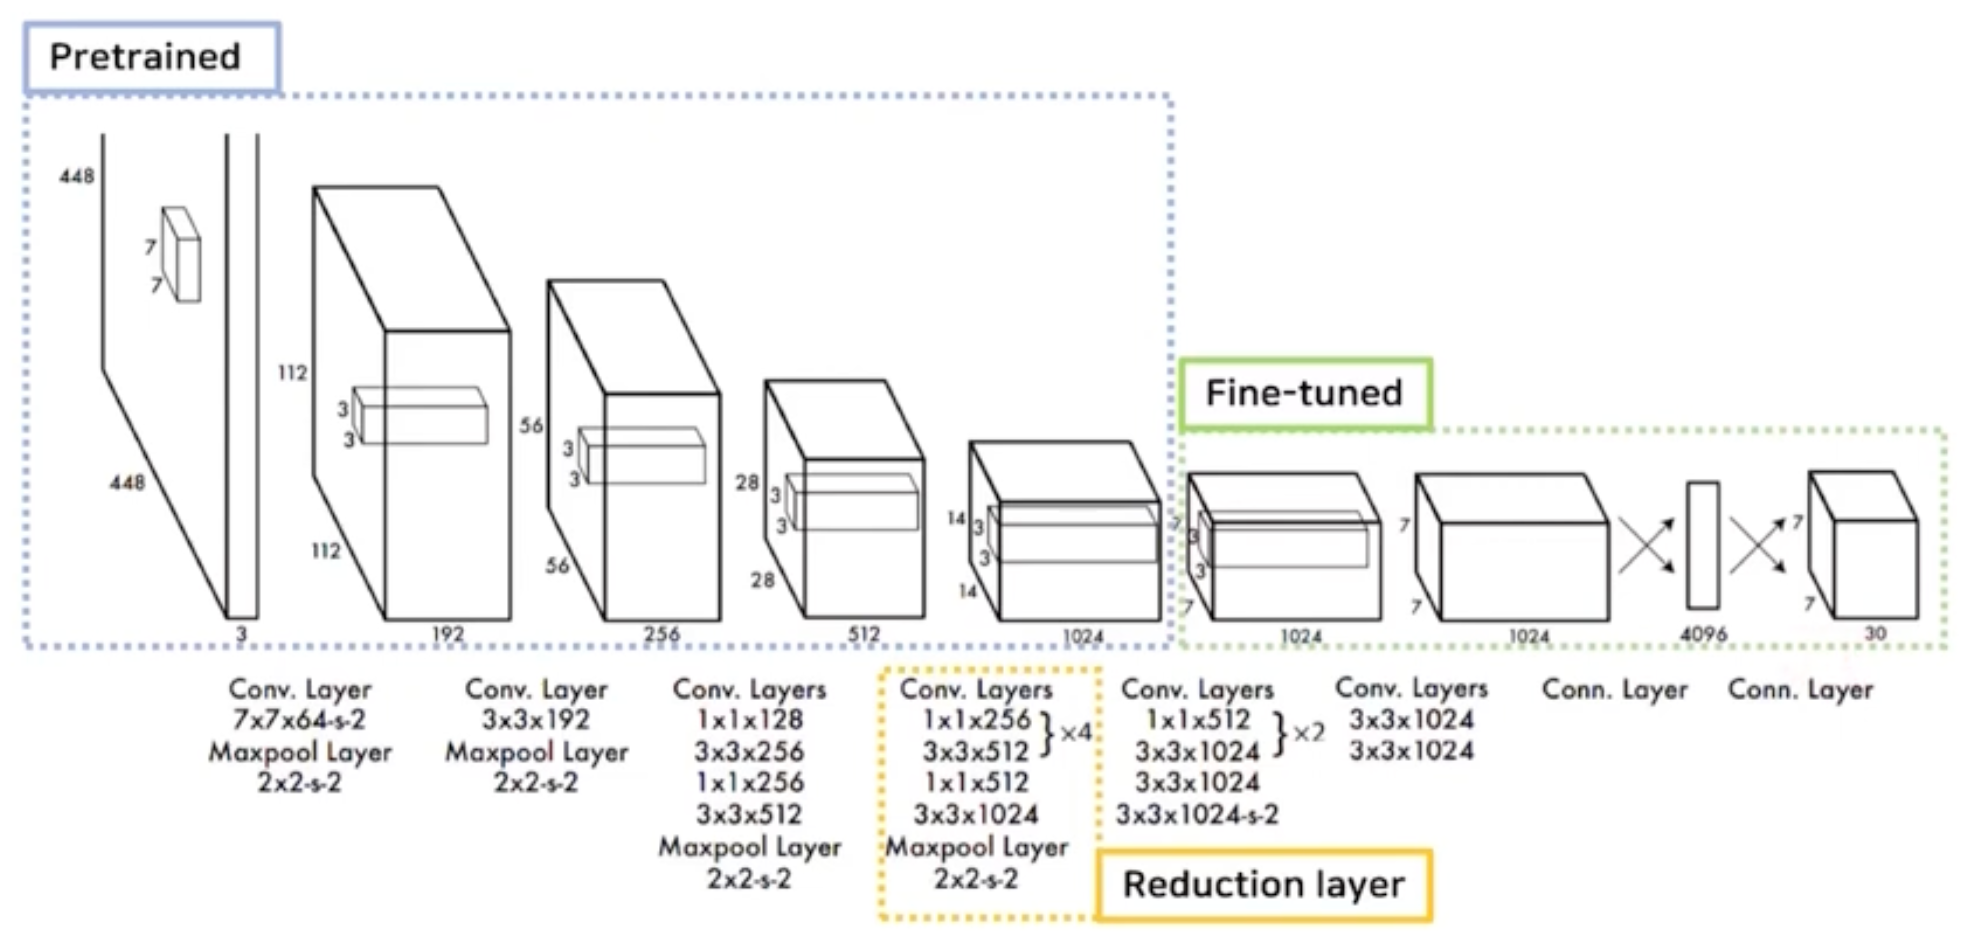
YOLO의 convolutional network는 image classification용 GoogLeNet architecture에서 영향을 받았다. CNN 부분에서는 \(1\times1\) convolution \(3\times3\) convolution을 반복해서 사용. (GoogLeNet: 큰 convolution을 하기 전에 \(1\times1\) Conv로 channel 수를 줄여서 계산량을 줄이자)
24 Conv Layer + 2 FC Layer / Fast Yolo: 9 Conv Layer + 2 FC Layer
- Pretrained: 20 Conv Layer, pretrained with 1000-class ImageNet (input image: 224 x 224) visual feature를 잘 추출하도록 weight가 학습
- Fine-tuned: 4 Conv Layer + 2 FC Layer, fined-tuned with PASCAL VOC (input image: 448 x 448)
Reduction Layer: 중간에 1 x 1 reduction layer로 연산량 감소.
2.2 Training
(개인 필기로 대체)
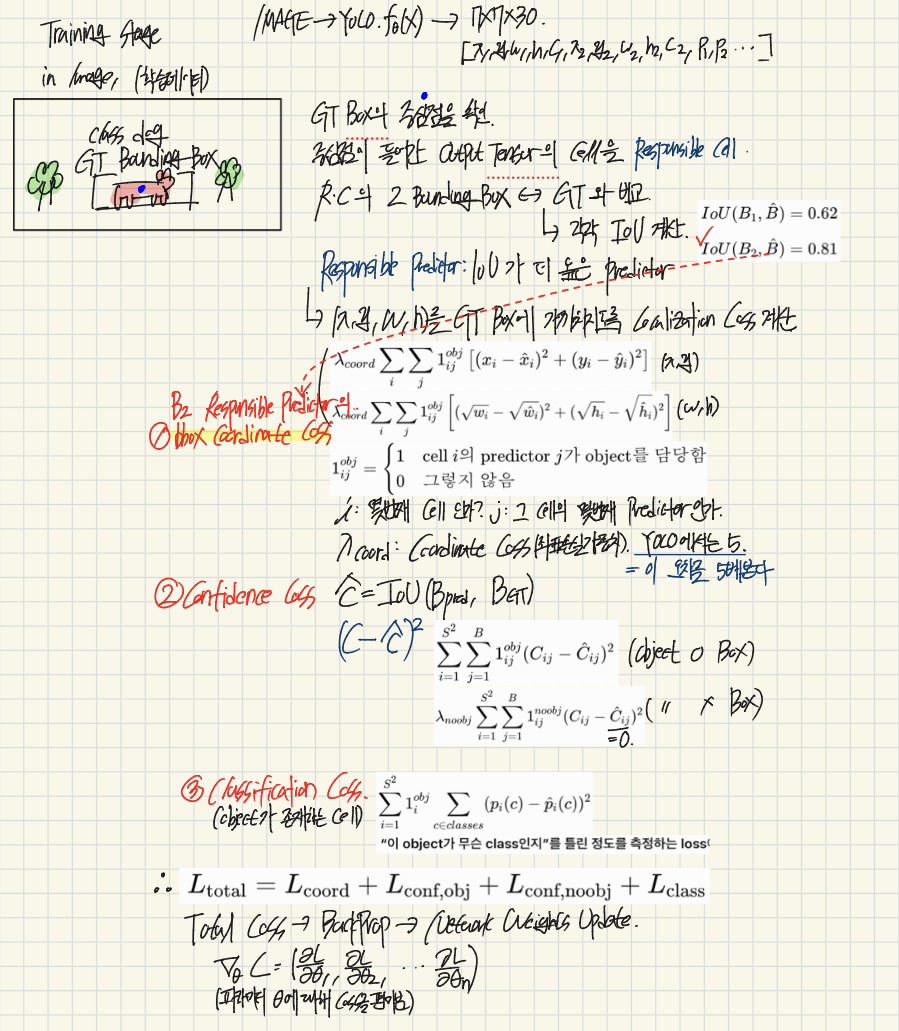
특정 object에 대해 reponsible 한 cell i는 GT box의 중심이 위치하는 cell로 할당. YOLO는 여러 bbox를 예측하지만, 학습단계에서는 IoU가 가장 높은 bbox 1개만 사용됨.
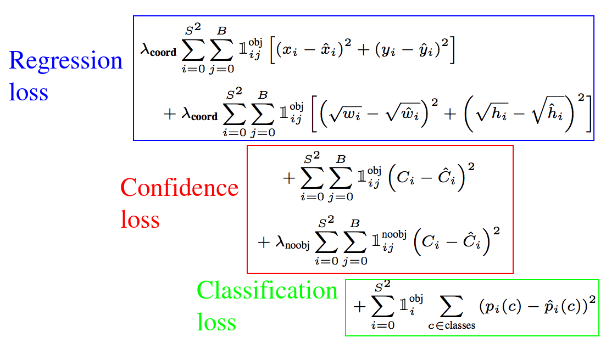
2.3 Inference
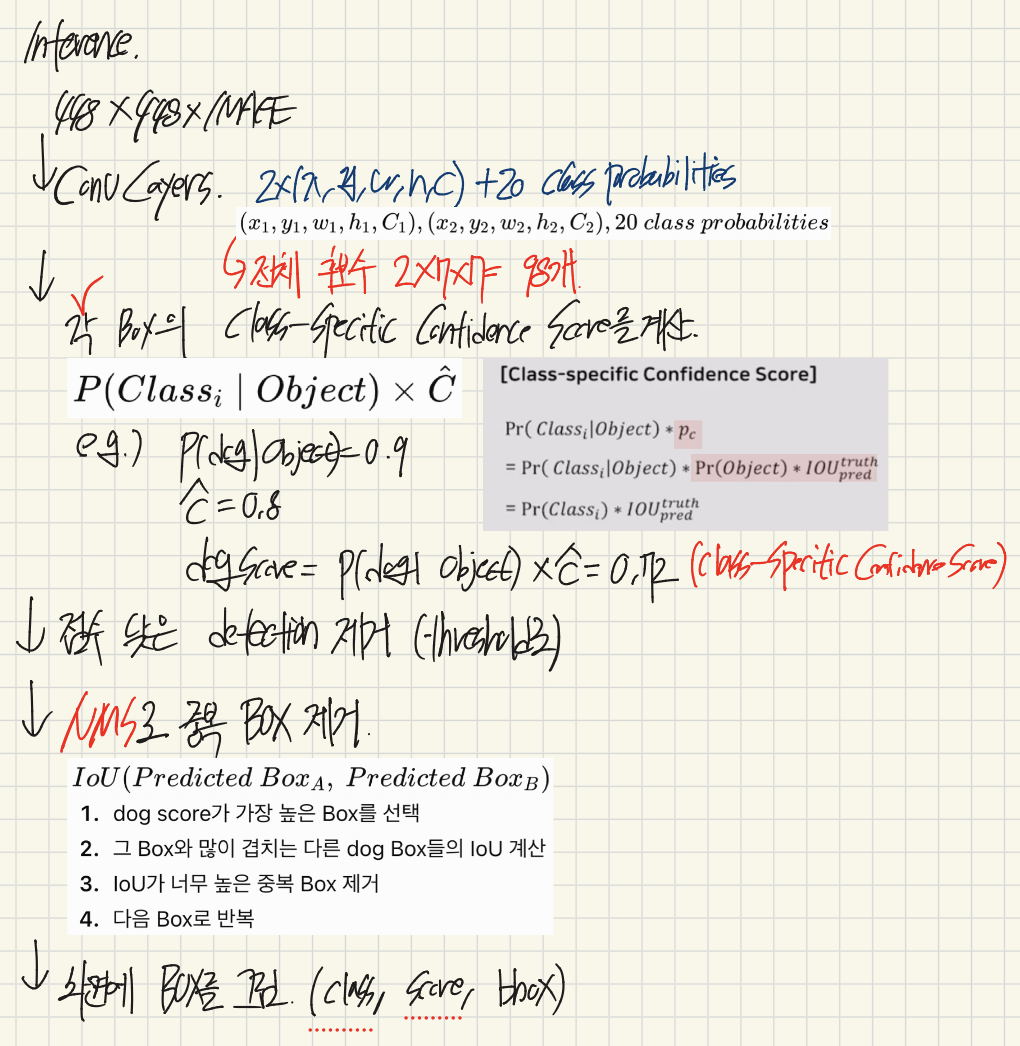
Non-Maximum Suppression: 각 object에 대해 예측한 여러 bbox 중에서 가장 예측력 좋은 bbox만 남기기 위함.
4. Experiment
4.1. Comparison to Other Real-Time Systems
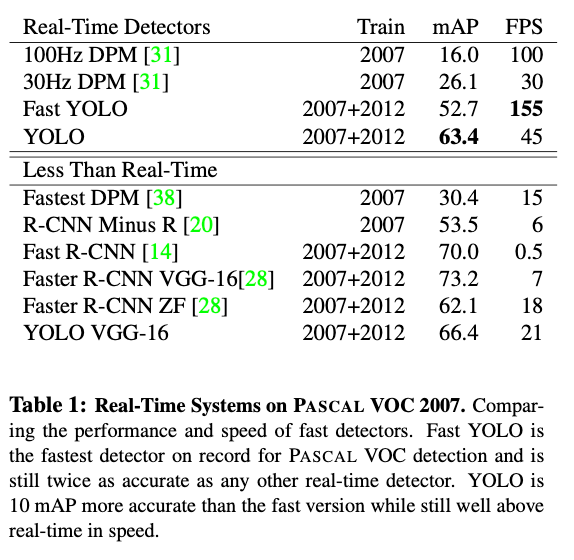
Dataset: PASCAL VOC 2007
YOLO의 mAP 63.4로 SOTA는 아니었지만, 실시간 Detector 중에서는 매우 높은 정확도를 보여줬다. (Fast YOLO는 155 FPS)
Faster R-CNN VGG-16이 YOLO보다 약 10 mAP 높지만 약 6배 느리다. (실시간과 거리가 매우 멂)
4.2. VOC 2007 Error Analysis
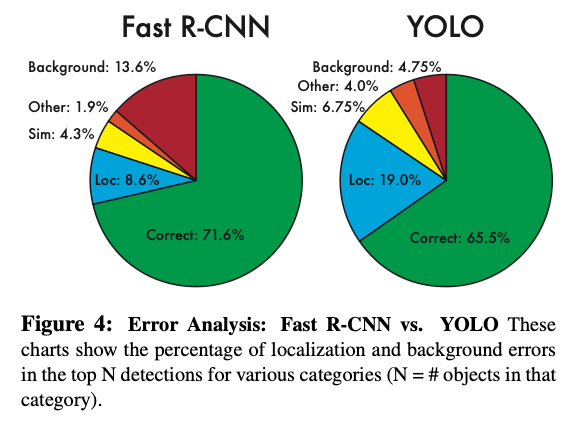
YOLO
- Correct: 65.5%
- Localization error: 19.0%
- Background error: 4.75%
- 기타 오분류 존재
Correct 는 Fast R-CNN이 더 높다.
하지만 YOLO의 장점은 Background Error (\(IoU < 0.1\), 실제로 아무것도 없는 배경을 보고 “여기 object 있어”라고 잘못 검출한 것) 가 매우 작다는 것에 있다.
YOLO의 대표적인 약점은 Localization Error가 많다는 것에 있다.
반대로, Faster R-CNN은 BOX 위치는 더 잘 잡지만 배경을 object로 잘못 보는 false positive가 많다.
그래서 저자들은 둘이 틀리는 방식이 다르면, 둘을 합치면 성능이 좋아지지 않을까 란 생각으로 아래와 같은 실험을 진행하였다.
4.3. Combining Fast R-CNN and YOLO
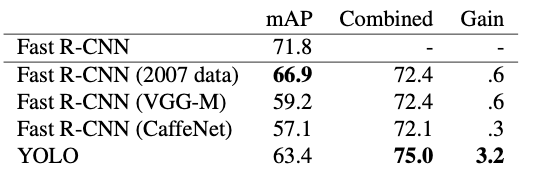
실험결과 Fast R-CNN 과 YOLO를 결합하면 \(75.0\ \text{mAP}\) 로 + 3.2 mAP 로 올라간다.
4.5. Generalizability: Person Detection in Artwork
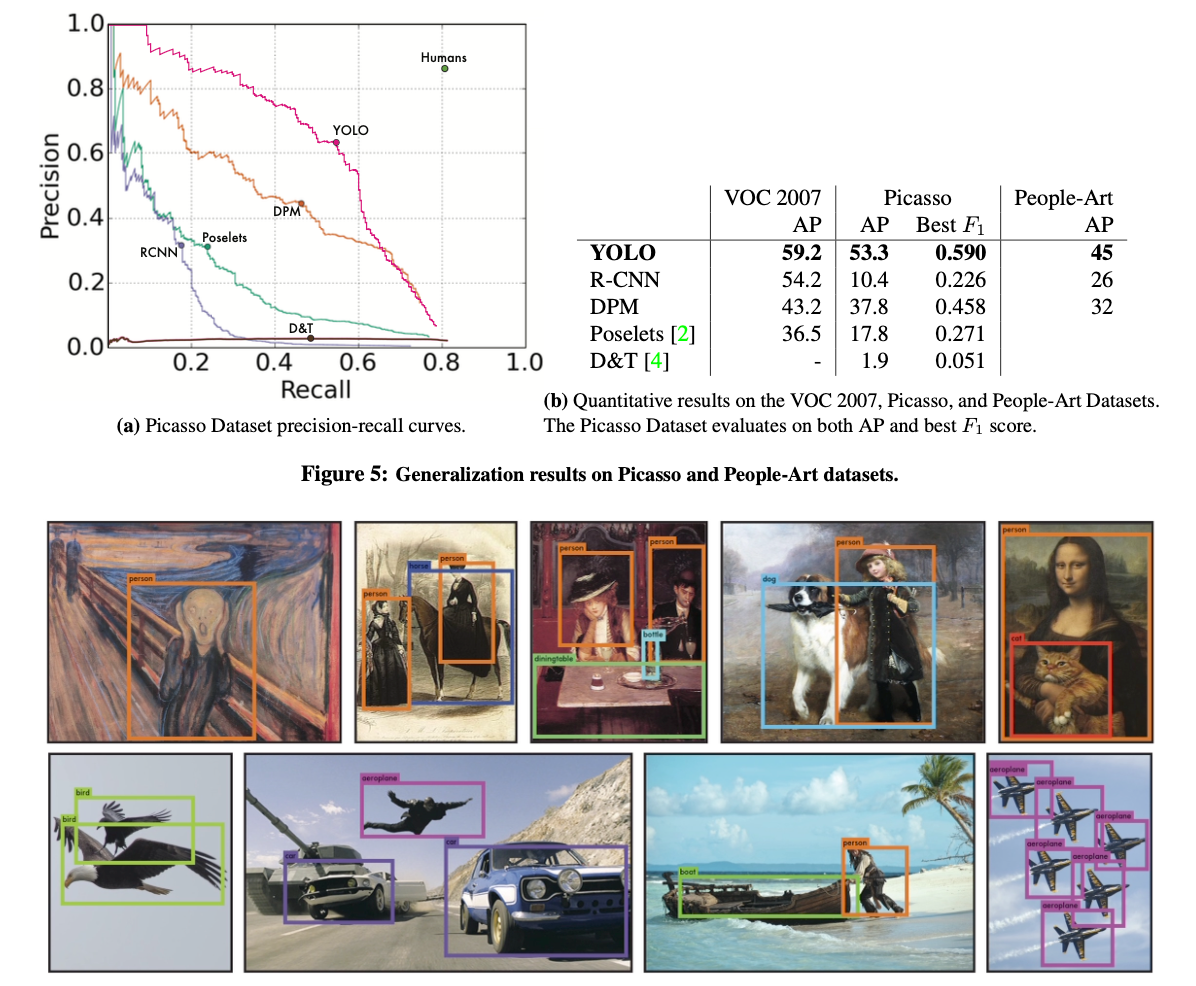
Dataset: Picasso Dataset, People-Art Dataset
사람을 찾아내는 Person Detection을 진행하였고, YOLO는 다양한 도메인에서도 robust한 detection 성능을 보임.
YOLO가 단순히 object의 일부분이나 local texture만 보는 것이 아니라 이미지 전체를 한 번에 보고 object의 shape와 contextual information을 함께 활용하기 때문에 다른 도메인에서도 상대적으로 잘 일반화함.
반대로 R-CNN 계열은 region 중심으로 object를 보는 방식이라, 사진과 그림 사이의 appearance 변화에 더 민감한 모습을 보임.
Limitations
작은 물체에 약함
- 작은 물체는 feature가 많이 손실되기 쉽고, 여러 작은 물체가 한 grid cell에 몰리면 표현하기 어렵다.
- 작은 Box는 좌표가 조금만 틀려도 IoU가 크게 떨어진다.
밀집된 물체에 약함
- 한 cell이 예측할 수 있는 Box와 class 표현 수가 제한적이라, 작은 물체 여러 개가 같은 cell에 들어오면 놓치기 쉽다.
새로운 비율/형태에 약함
- 학습 때 보지 못한 특이한 aspect ratio나 object configuration이 나오면 Bounding Box regression이 잘 안 될 수 있다.
(Background) Metrics
FPS (V100, FP32)
FPS: 모델이 1초에 이미 몇 장을 처리할 수 있느냐 (10FPS: 초당 10장)
V100 = NVIDIA Tesla V100 GPU에서 측정했다는 뜻
FP32 = 모델 계산을 32-bit floating point로 수행했다는 뜻
IoU(Intersection over Union): 두 Box가 겹쳐진 영역 / 두 Box를 합친 전체 영역
(예측 Box 와 정답(GT) Box)
1
2
3
4
IoU = 1.0 → 완전히 일치
IoU = 0.8 → 상당히 잘 맞음
IoU = 0.3 → 별로 안 맞음
IoU = 0 → 아예 안 겹침
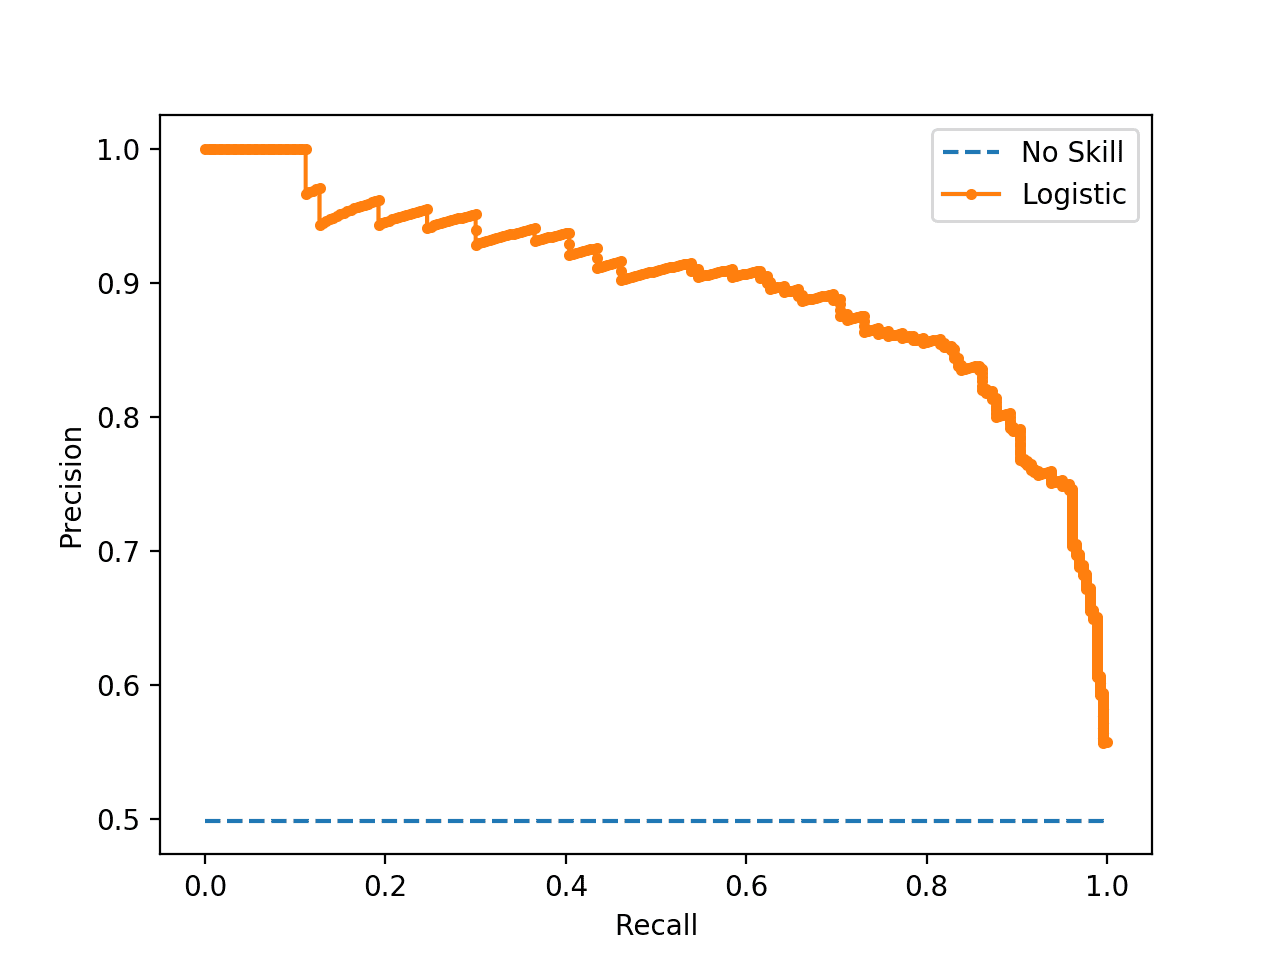
AP (Average Precision): 한 클래스에 대해 모델이 얼마나 정확하게 탐지하는지를 하나의 숫자로 나타낸 것 (Precision - Recall Curve 아래의 면적)
\(\boxed{AP_t = \text{PR curve의 면적, 단 TP를 } IoU\ge t\text{일 때만 인정}}\)
IoU는 AP를 계산하기 위한 정답 판정 기준이고, AP는 그 기준 아래에서 모델 전체가 얼마나 잘 탐지하는지를 평가하는 점수.
❓헷갈렸던 점: AP와 IoU의 관계성
e.g.) AP75: 예측 Box가 GT Box 와 IOU >= 0.75 이상일 때만 “맞춘 것(TP)”로 인정하겠다.
1
2
3
4
5
6
7
1. 모델이 여러 개의 Bounding Box + Confidence를 예측함
2. 각 예측 Box를 정답 GT Box와 비교해서 IoU 계산
3. IoU ≥ 0.75면 TP, 아니면 FP로 판정
4. 예측들을 Confidence 높은 순서대로 정렬
5. 위에서부터 하나씩 포함하면서 Precision, Recall 계산
6. 그 점들로 PR Curve 생성
7. PR Curve 아래 면적 = AP75
mAP (mean Average Precision): AP를 여러 클래스에 대해 구한 다음 평균낸 것. 전체 클래스에 대한 평균 detection 능력.
Confidence threshold(신뢰도 임계값): 인공지능(AI)이나 머신러닝 모델이 내린 예측 결과의 확신 점수(Confidence score)를 수용할지 여부를 결정하는 기준선
COCO mAP: 여러 IoU 기준에서 계산한 AP를 평균낸 점수. \(\text{AP50,\ AP55,\ AP60,\ \dots,\ AP95}\)