[Multimodal] Hugging Face Community Computer Vision Course - Multimodal Tasks and Models
🔗 Reference - Community Computer Vision Course documentation, Multimodal Tasks and Models
1. Multimodal Tasks and Models
인간의 세계는 다양한 감각 입력의 조합으로 이루어져 있다. 우리는 시각, 청각, 촉각 등을 통해 세상을 인식하고 이해함.
이러한 멀티모달성(multimodality)은 여러 종류의 정보를 함께 이용한다는 점에서 하나의 종류의 정보만 처리하는 기존 단일모달 AI 모델과 구분됨.
멀티모달 모델은 텍스트, 이미지, 오디오, 센서 데이터와 같은 여러 출처의 정보를 통합함으로써 이러한 차이를 줄이는 것을 목표로 함.
modality
모델에게 들어오는 정보의 종류
텍스트 → text modality
이미지 → image modality
음성 → audio modality
2. Examples of Tasks
2.1 Visual Question Answering(VQA) and Visual Reasoning
Visual Question Answering(VQA)
이미지나 영상을 보고 이에 대한 사람의 자연어 질문에 AI가 알맞은 답변을 텍스트로 찾아내거나 생성하는 기술
Visual Reasoning
단순히 물체를 인식하는 것을 넘어, 물체 사이의 관계를 추론하고 물체들을 비교하며, 장면 전체의 맥락을 이해해 정확한 답을 내도록함.
이미지에서 특징을 추출하는 것뿐 아니라 이미지 특징 + 질문의 의미를 서로 연결해야함.
| 구분 | VQA | Visual Reasoning |
|---|---|---|
| 의미 | 이미지에 대해 질문하고 답하기 | 이미지 정보를 바탕으로 추론하기 |
| 핵심 | 질문-답변 형식 | 추론 과정 |
| 난이도 | 단순 인식부터 복잡한 추론까지 | 보통 관계·논리·공간 추론 요구 |
| 예시 | “몇 명이 있나?” → 3명 | “A가 B보다 왼쪽이고 B가 C보다 왼쪽이면 A와 C의 관계는?” |
VQA는 Task 형식이고, Visual Reasoning은 필요한 능력이라고 보면 됨.
2.2 Document Visual Question Answering, DocVQA
DocVQA
문서 이미지를 보고 문서의 글자와 배치·표·구조 등 시각적 정보를 함께 이해하여 자연어 질문에 답하는 기술.
컴퓨터 비전을 이용해 이미지의 시각적 요소를 처리하고, 자연어 처리를 이용해 텍스트를 해석함으로써 사람이 문서를 읽듯 문서를 이해하고 질문에 답함.
DocVQA는
1
2
3
4
5
무슨 글자인가?
+
문서의 어디에 있는가?
+
다른 글자와 어떤 위치 관계인가?
까지 본다.
2.3 Image Captioning
Image Captioning
이미지의 객체, 행동, 관계, 전체 상황을 이해하여 그 내용을 설명하는 자연어 문장을 자동으로 생성하는 기술.
즉, 시각과 언어 사이의 간극을 연결하는 Task 임.
❓ VQA 와는 뭐가 다를까?
1
2
3
VQA
image + question
→ answer
반면
1
2
3
Image Captioning
image
→ "A dog is running on the grass."
즉 컴퓨터가 이미지 한 장씩 세상을 말로 설명하도록 하는 기술이라고 보면 됨.
2.4 Image-Text Retrieval
Image-Text Retrieval
이미지와 텍스트의 의미적 연관성을 비교하여 텍스트로 관련 이미지를 찾거나, 이미지로 관련 텍스트를 찾는 검색 기술.
2.5 Visual Grounding
Visual Grounding
자연어 표현이 이미지 속 어떤 객체나 영역을 가리키는지 찾아 연결하는 기술. 예를 들어 “빨간 사과”라는 문장이 가리키는 위치를 이미지에서 찾는다.
1
"오른쪽 아래에 있는 빨간 사과를 찾아."
처럼 텍스트를 조건으로 물체를 찾는다.
결과는 보통
1
(x1, y1, x2, y2)
형태의 Bounding Box 이다.
2.6 Text-to-Image Generation
Text-to-Image Generation
사용자가 입력한 자연어 설명을 이해하여 그 내용과 대응하는 새로운 이미지를 생성하는 기술.
3. Visual Question Anwering (VQA) and Visual Reasoning
일반적으로 VQA와 Visual Reasoning 모두 넓은 의미에서 Visual Question Answering 태스크로 취급됨.
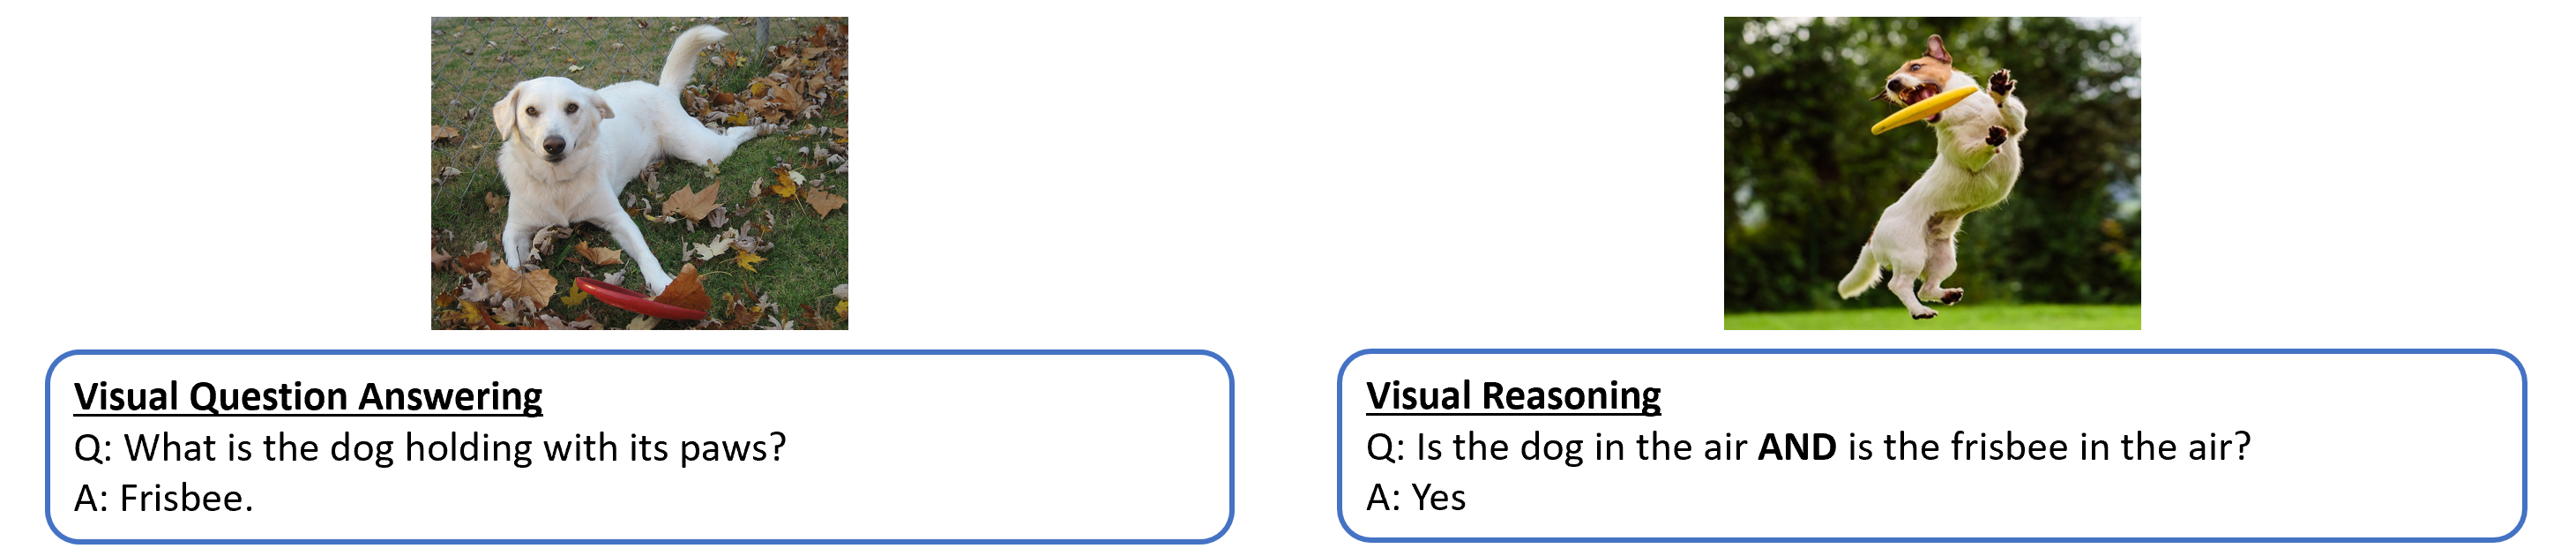
Visual Question Answering (VQA)
Input
이미지와 그 이미지에 대한 질문의 쌍. (Image, Question)
Ouput
객관식: 미리 정의된 답 중 올바른 답에 해당하는 label을 출력.
자유응답방식: 이미지와 질문을 기반으로 자연어 답변을 생성함.
Task
이미지에 대한 질문에 답하는 것.
많은 전통적인 VQA 모델에서는 이를 미리 정의된 답들 중 하나를 선택하는 classification 문제로 처리함.
Visual Reasoning
입력은 Task에 따라 달라짐.
Input
- VQA 형태
Image + Question - Matching
Image + Text statement - Entailment
Image + Text
경우에 따라 여러 문장이 들어갈 수 있다. - Sub-question
주 질문과 함께 이미지 인식과 관련된 보조 질문들이 주어진다.
Output
- VQA
이미지에 대한 질문의 답. - Matching
텍스트 내용이 이미지에 대해 맞는지
True / False
를 예측한다. - Entailment
이미지가 텍스트 내용을 의미적으로 뒷받침하는지(entail) 예측한다. - Sub-question
이미지의 시각 정보와 관련된 보조 질문에 답한다.
3.1 BLIP-VQA
BLIP-VQA는 Salesforce AI가 개발한 대규모 사전학습 VQA 모델임.
BLIP는 Bootstrapping Language-Image Pre-training이라는 방법을 사용함.
웹에서 수집한 노이즈가 포함된 데이터와 이미지 caption 생성을 함께 활용하여 다양한 vision-language 태스크에서 높은 성능을 얻음.
❓ Bootstrapping 이란?
웹의 image-caption 데이터는 매우 많지만 caption 품질이 항상 좋지는 않다. BLIP는 이런 noisy caption을 그대로 믿기보다
1
2
3
웹 데이터
→ caption을 생성/검사
→ 품질 좋은 image-text pair 활용 하는 방식을 사용함.
3.2 DePlot
Deplot은 그래프나 차트 이미지를 읽어 그 안의 데이터를 표 형태의 텍스트로 변환하도록 학습된 one-shot vision-language reasoning model임.
변환된 데이터를 LLM에 넘겨 차트에 대한 복잡한 질문에도 답할 수 있게 한다.
예를 들어 막대그래프가 있으면 바로 질문에 답하려 하기보다는,
1
2
3
4
5
6
7
그래프 이미지
↓
표 형태의 데이터
↓
LLM
↓
질문 답변
방식으로 처리하는 모델임.
3.3 ViLT (Vision-and-Language Transformer)
이미지와 텍스트를 하나의 Transformer에서 직접 함께 처리하는 Vision-Language 모델.
별도의 CNN이나 객체 탐지기를 사용하지 않고 이미지 패치와 텍스트를 결합해 처리한다.
VQAv2 데이터셋을 이용해 자연어 이미지 질문에 답하도록 fine-tuning되어있음.
ViLT의 기본 모델은 B32 크기의 비교적 큰 구조를 사용하고, 이미지와 텍스트를 함께 학습함. 이 덕분에 여러 vision-language task, 특히 VQA에서 경쟁력 있는 성능을 보임.
Vision Transformer
Vit는 이미지를 작은 조각인 patch로 나눔.
224×224 → image 16×16 patch들로 분할.
그러면 하나의 patch를 NLP에서의 token 하나처럼 취급할 수 있음.
이렇게 만든 이미지 token들을 Transformer에 넣어, rough하게 설명하면 image → patches → tokens → Transformer 처럼 처리.
4. Document Visual Question Answering (DocVQA)
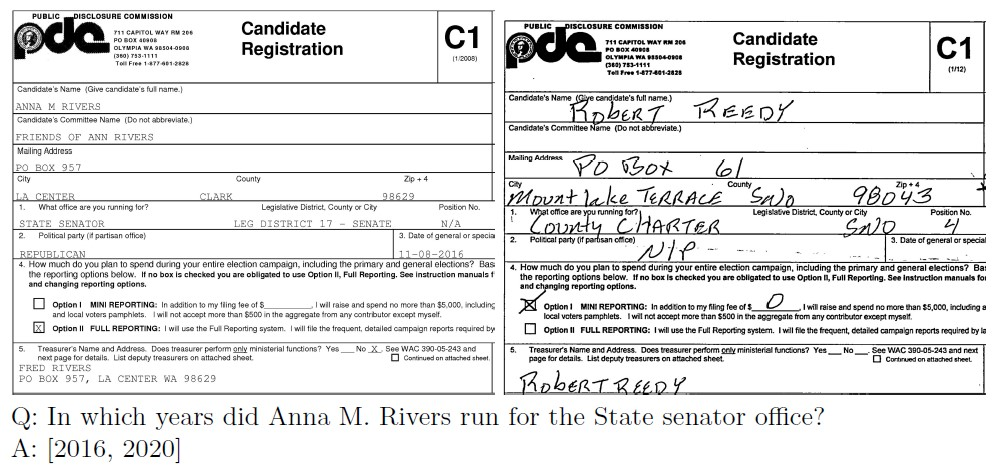
Input
- Document Image
스캔 또는 디지털 문서 이미지. (그 안에는 글자, 레이아웃, 이미지 등의 시각요소가 들어있음) - Question
문서에 관한 자연어 질문.
Task
- 모델은 먼저 문서 안의 시각 정보와 텍스트 정보를 함께 분석하고 이해해야함.
- 그 다음 이미지의 시각 요소, 텍스트, 질문 사이의 관계를 파악하여 필요한 결론을 추론해야함.
- 질문에 대한 명확하고 정확한 자연어 답변을 생성.
Output
문서 안에 있는 정보를 기반으로 질문에 직접 답하는 텍스트.
4.1 LayoutLM
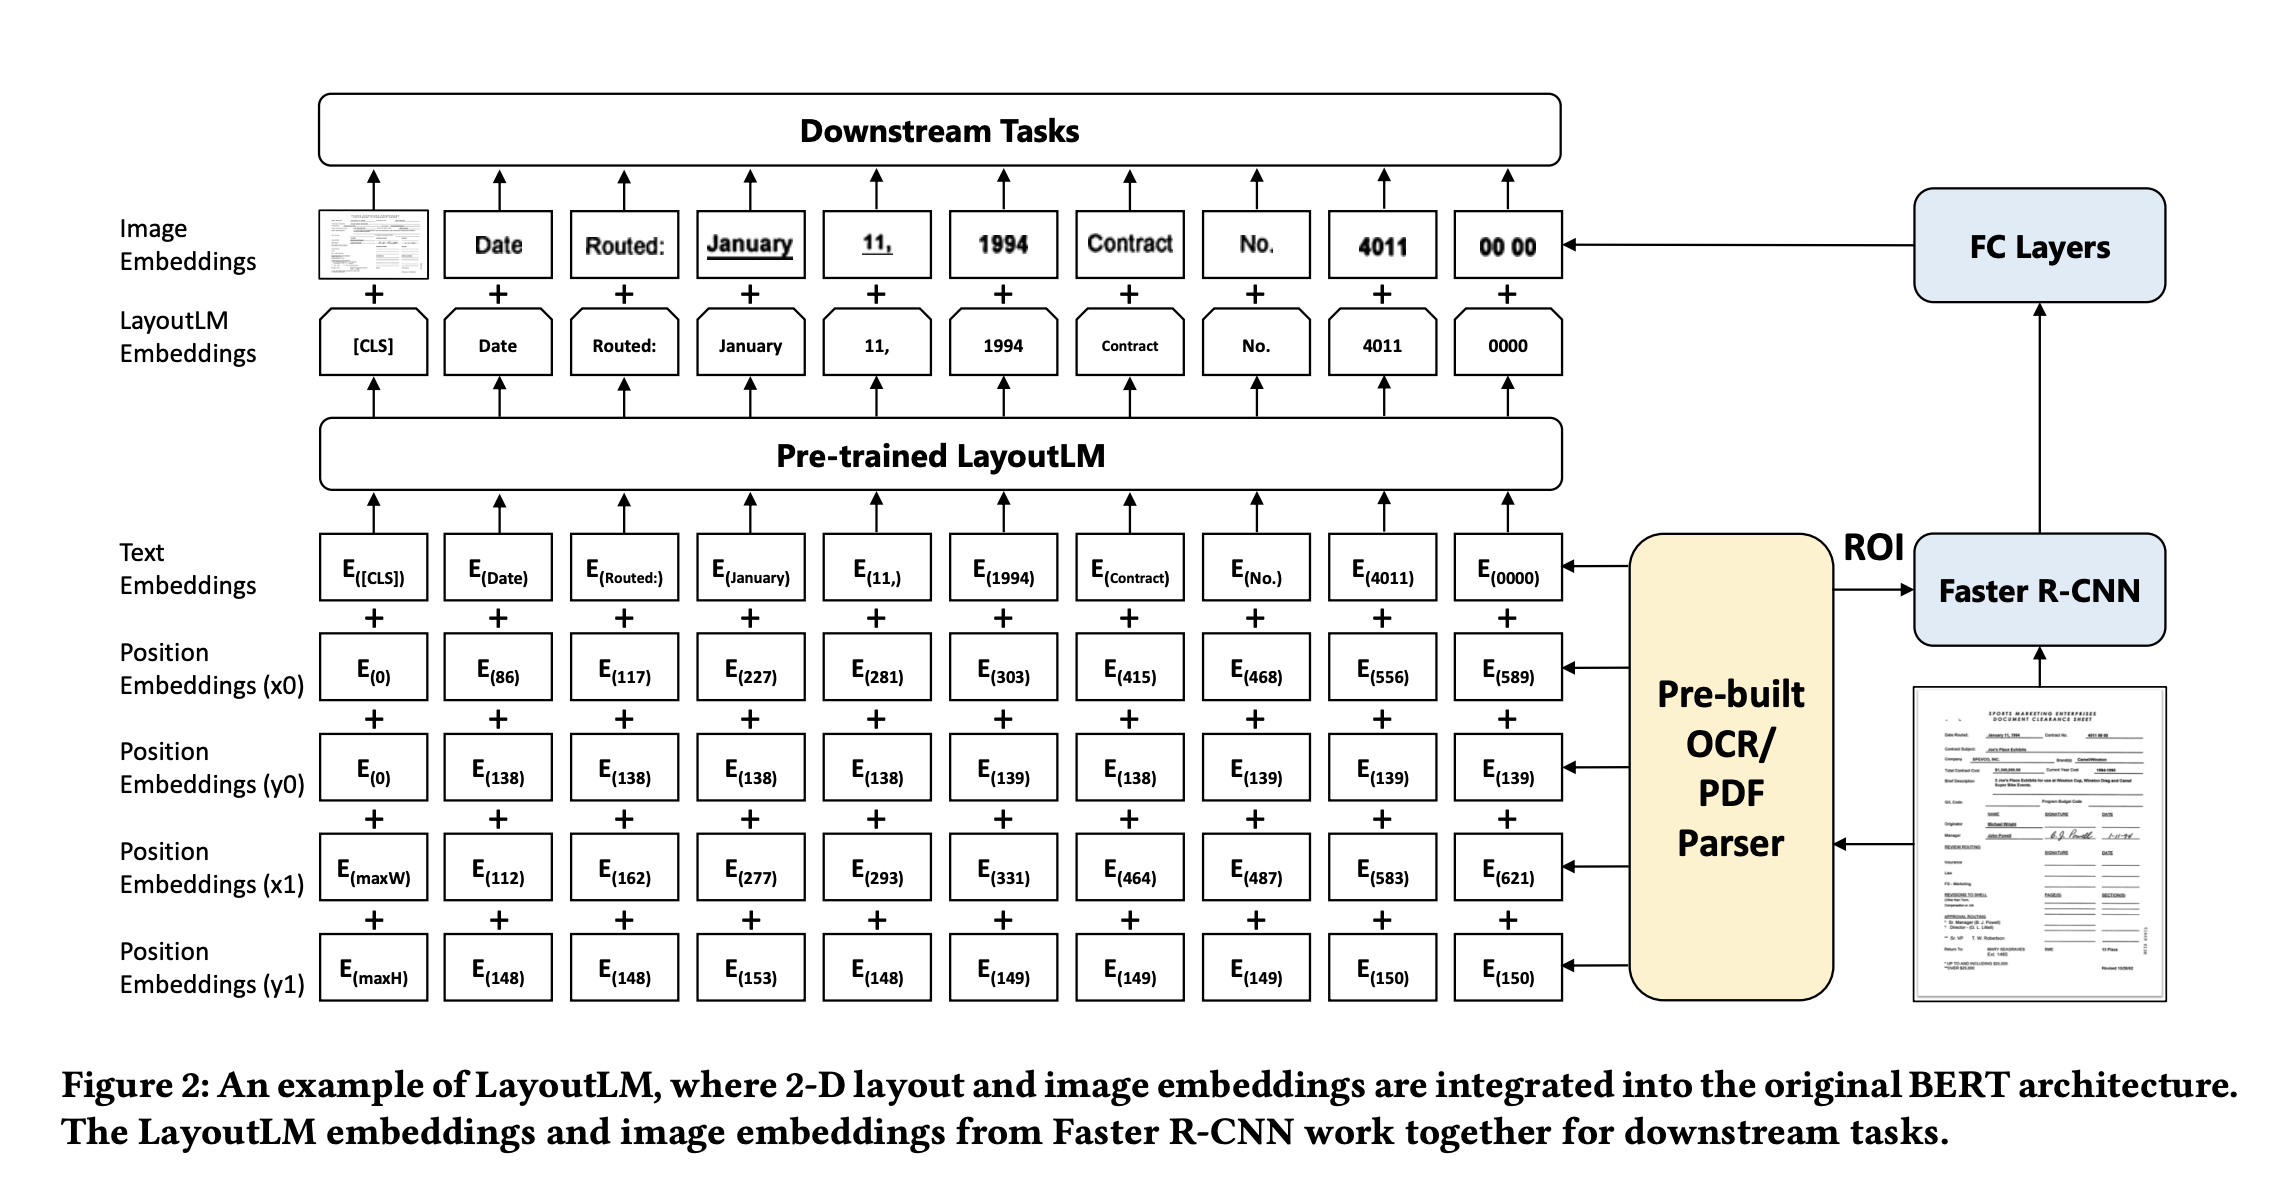
$\text 단어+문서상의 위치 (x,y)$ 를 같이 봄.
LayoutLM은 문서 이미지의 텍스트와 layout을 동시에 분석하는 사전학습 neural network.
즉, LayoutLM은 영수증, 계약서, 신청서 같은 문서 이미지를 이해하기 위해 텍스트 내용과 문서 안에서의 위치·배치 정보를 함께 학습하는 모델임.
글자의 크기, 위치, 주변 글자와의 거리 등을 고려하여 단어와 문맥의 관계를 학습함.
❓ Layout 이란?
글자, 문단, 표, 제목, 이미지 등이 어떻게 배치되고 서로 어떤 구조를 이루는지를 뜻함.
4.2 Donut
\(\text{Swin Transformer Encoder} \rightarrow \text{BART Decoder} \rightarrow \text{Text / Structured Output}\)
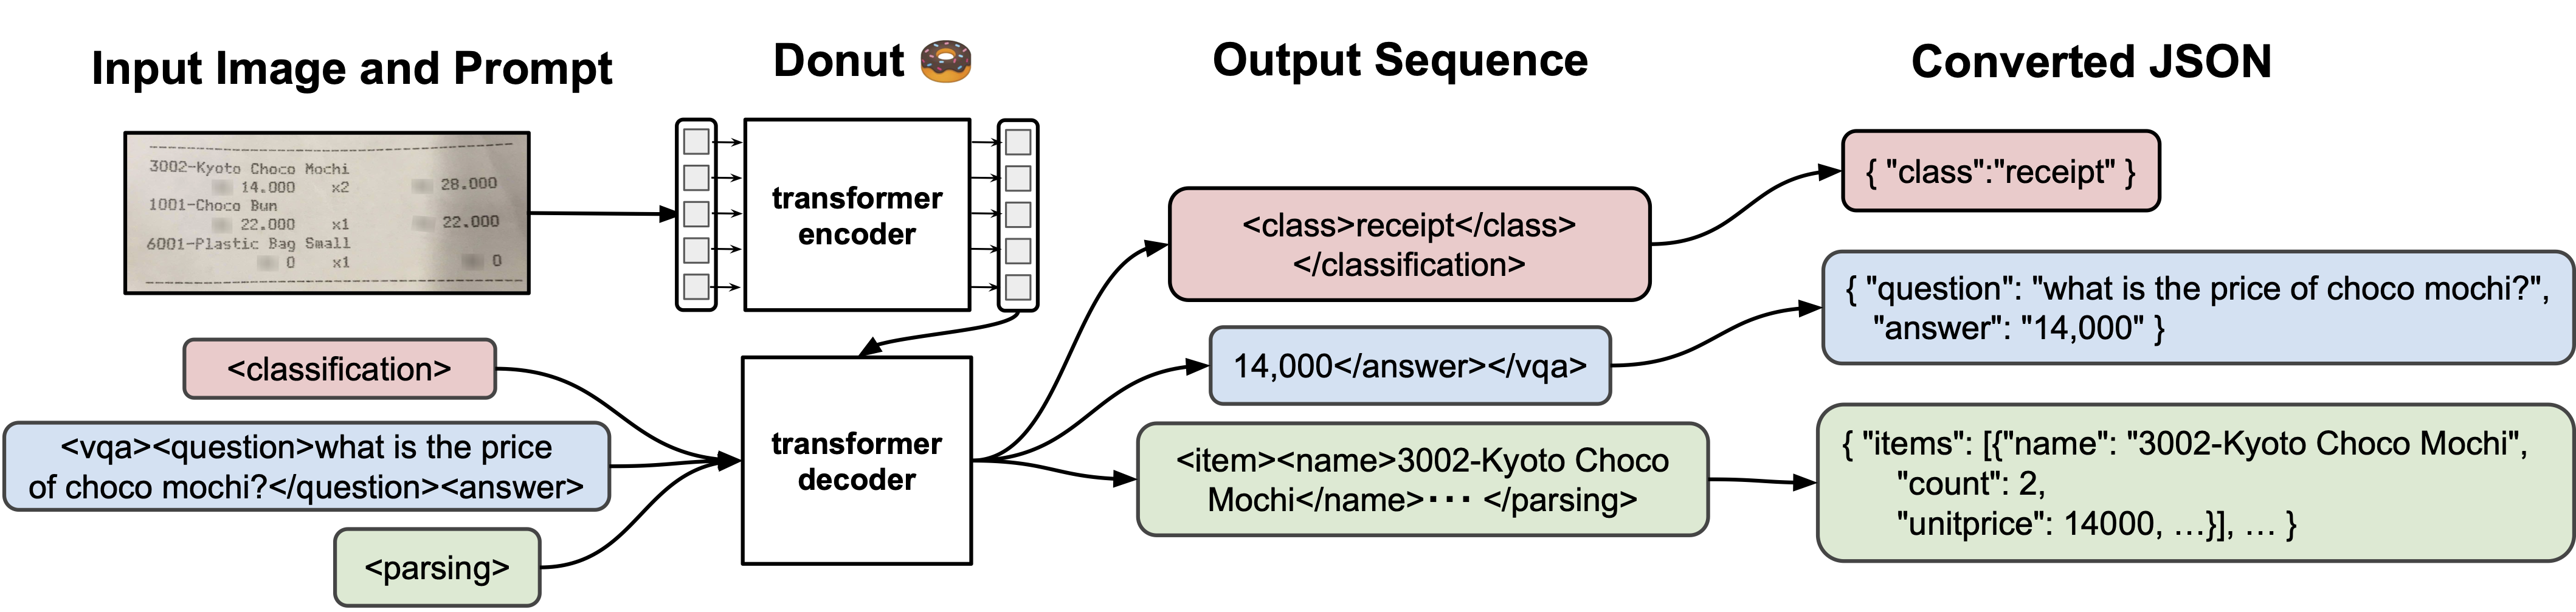
Donut은 OCR-free Document Understanding Transformer라고도 불림.
OCR을 따로 거치지 않고, 문서 이미지를 직접 보고 필요한 텍스트나 구조화된 정보를 생성하는 문서 이해 모델입니다. 영수증, 양식, 문서 분류, 정보 추출 등에 사용됨.
1
2
3
Vision Encoder: Swin Transformer
+
Text Decoder: BART
를 결합하여 문서 분류, form 이해, VQA 등을 수행함.
❓ Swin Transformer 이란?
이미지를 작은 윈도우(window) 단위로 나눠 각 영역 안에서 Self-Attention을 수행하는 Vision Transformer
1
2
3
4
5
6
7
8
9
10
┌──────┐ ┌──────┐
│ ① ② │ │ ③ ④ │
│ ⑤ ⑥ │ │ ⑦ ⑧ │
└──────┘ └──────┘

┌──────┐ ┌──────┐
│ ⑨ ⑩ │ │ ⑪ ⑫ │
│ ⑬ ⑭ │ │ ⑮ ⑯ │
└──────┘ └──────┘
처럼 작은 구역(window)를 묶어 ①에서는 ① ↔ ②,⑤,⑥ 처럼 같은 window 안의 patch만 봄.
다음 Transformer 층에서는 window 위치를 살짝 옮겨(shifted window), 이전에는 서로 다른 window에 있던 patch들이 다음 층에서는 같은 window에 들어오면서 정보를 주고받게 됨.
patch들을 다시 작은 window로 묶어서 그 안에서만 Attention하고, 다음 층에서 window를 이동시켜 다른 영역과도 정보를 주고받는다.
4.3 Nougat
\(\text{Scientific Document Image} \rightarrow \text{Swin Transformer Encoder} \rightarrow \text{mBART Decoder} \rightarrow \text{Markdown}\)
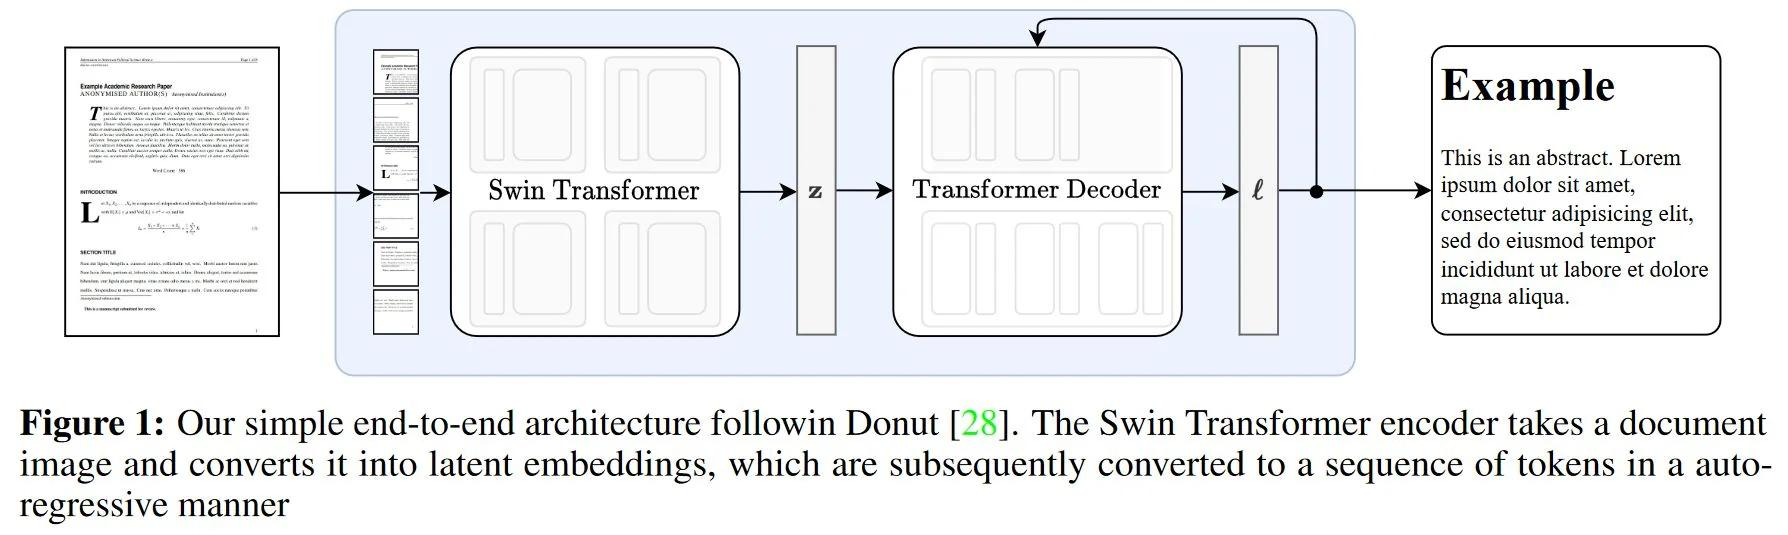
Nougat은 수백만 개의 학술 논문을 이용해 학습된 Visual Transformer 모델임.
특히 수식, 표와 같은 복잡한 요소도 이해할 수 있고, 전통적인 OCR 과정을 사용하지 않으면서도 의미 구조를 유지함.
Nougat ≈ Donut 구조를 과학 문서에 특화
| Donut | Nougat | |
|---|---|---|
| 입력 | 일반 문서 이미지 | 논문·과학 문서 이미지 |
| Encoder | Swin Transformer | Swin Transformer |
| Decoder | BART | mBART |
| 출력 | JSON, 답변, 분류 등 | Markdown |
| 목적 | 범용 문서 이해 | 논문/과학 문서 복원 |
5. Image Captioning
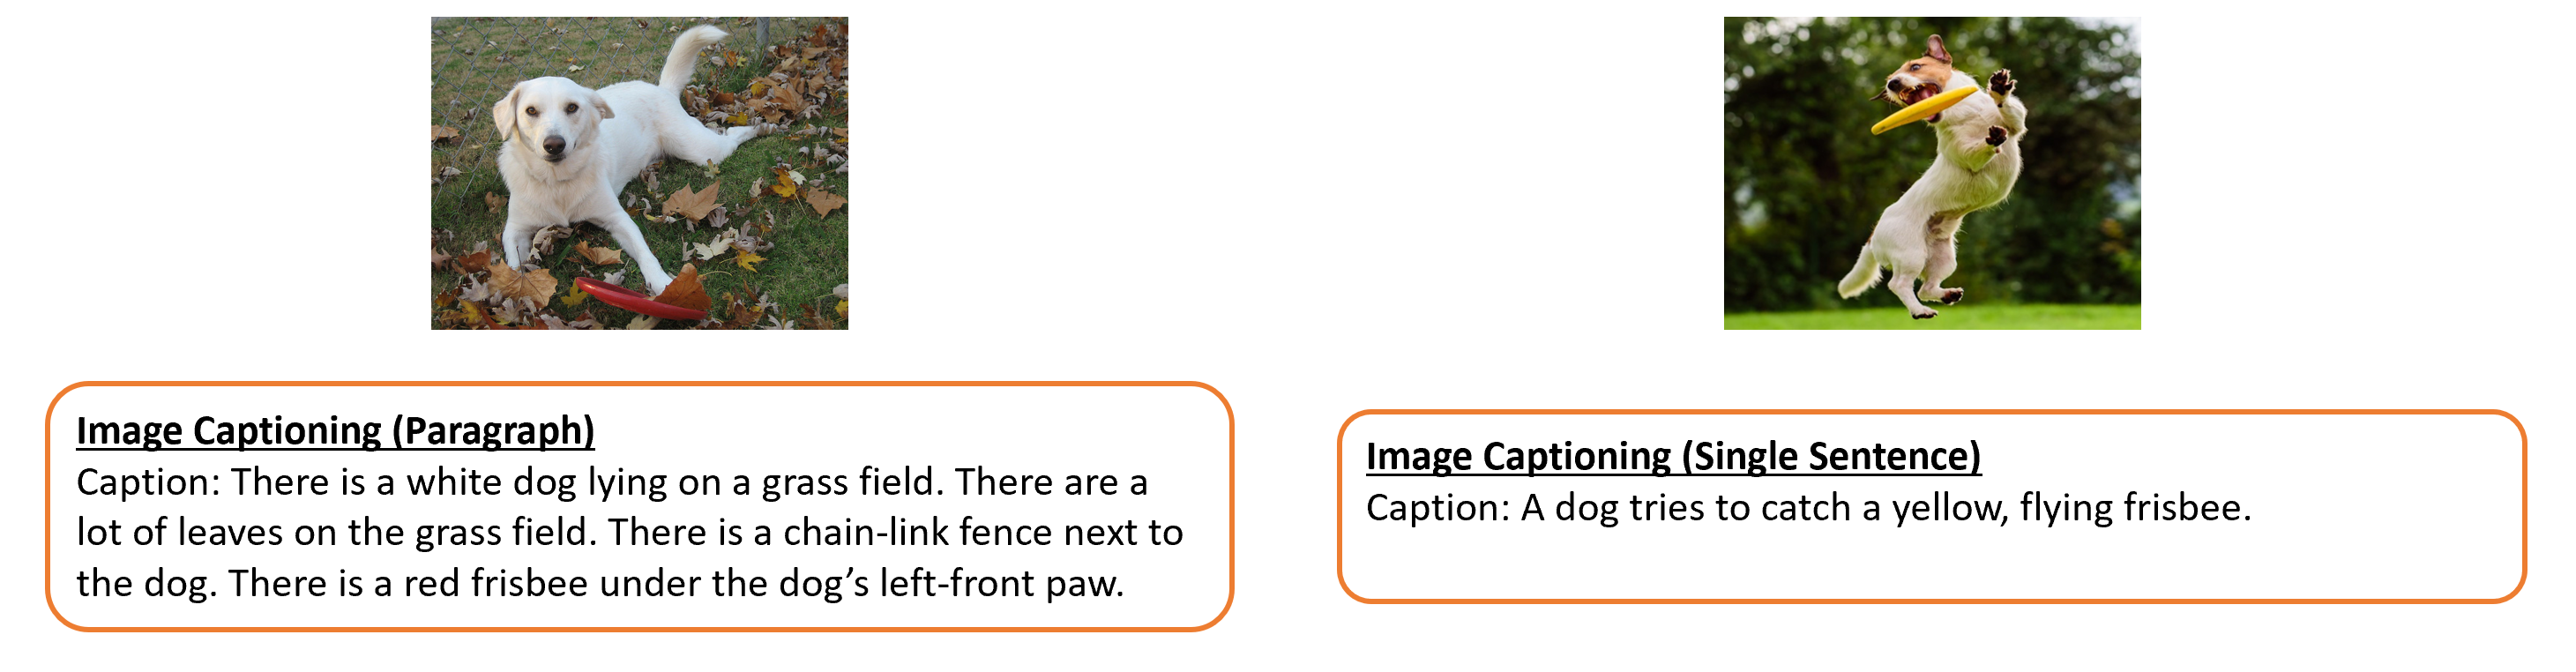
이미지를 보고, 그 이미지의 내용을 설명하는 자연어 문장을 자동으로 생성하는 기술
Input
Image: Image in various formats (e.g., JPEG, PNG).
사전학습된 image feature extractor (optional):이미지에서 의미 있는 특징을 먼저 뽑아주는 사전학습된 모델. (ex. CNN)
Ouput
Textual Caption, 즉 이미지를 설명하는 텍스트
"A dog is running through a field."
처럼 이미지에 있는 객체(Object), 행동(Action), 객체 간 관계(Relationship), 전체 상황(Context) 을 포함한 문장이나 문단을 생성하는 것이 목적임.
Task
이미지에 대한 자연어 설명을 자동으로 생성하는 것.
1
2
3
1. 이미지의 시각적 내용 이해
2. 시각 정보를 의미 있는 representation으로 변환
3. representation을 자연어 문장으로 decoding
5.1 ViT-GPT2
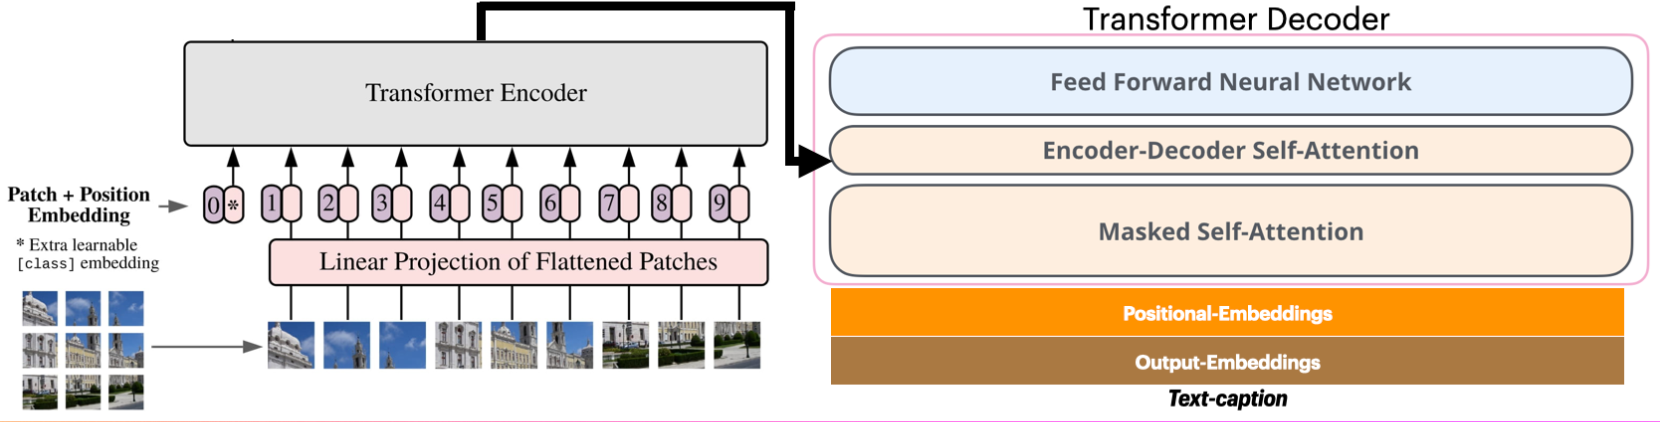
ViT-GPT2는 이미지의 특징을 추출하는 ViT(Vision Transformer)와
텍스트를 생성하는 GPT-2를 결합한 Image Captioning 모델임.
\(\text{Image} \rightarrow \text{ViT} \rightarrow \text{GPT-2} \rightarrow \text{Caption}\)
- ViT: 이미지를 이해하고 시각적 특징을 추출
- GPT-2: 추출된 이미지 정보를 바탕으로 문장을 생성
시각 특징을 추출하기 위해 Vision Transformer(ViT)를 사용하고, 텍스트를 생성하기 위해 GPT-2를 사용.
COCO dataset으로 학습됨.
❓ COCO dataset 이란?
본문의 “Trained on the COCO dataset”에서 COCO는 이미지와 그 이미지에 대한 설명 문장이 함께 들어 있는 대표적인 Computer Vision 데이터셋입니다.
5.2 BLIP Image Captioning
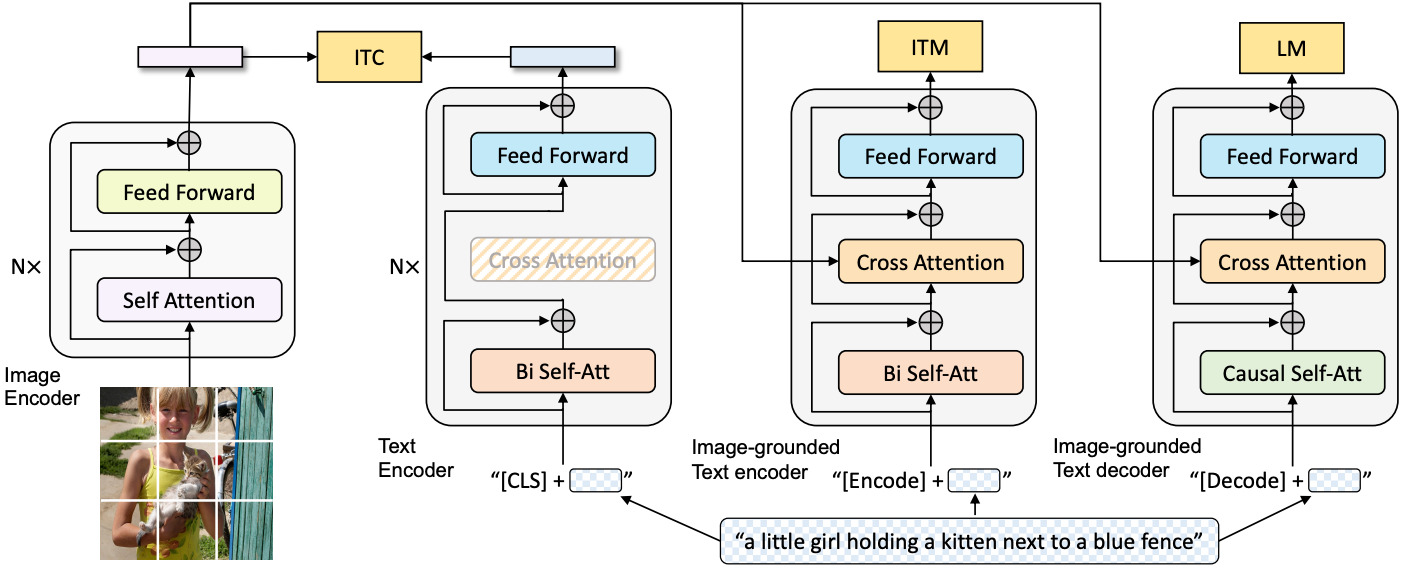
BLIP Image Captioning: noisy한 웹 image-text 데이터를 생성·필터링하며 학습하고, 이미지를 이해해 자연어 caption을 생성하는 Vision-Language 모델.
BLIP (Bootstrapping Language-Image Pre-training)은 이미지와 텍스트를 함께 학습해 이미지 이해와 텍스트 생성 작업을 모두 수행할 수 있도록 만든 Vision-Language 모델.
BLIP는 깨끗한 데이터와 noisy web data 모두를 이용하여 vision-language 이해와 생성을 위해 pre-training된다.
BLIP는 bootstrapping 과정을 이용해 노이즈가 많은 caption을 filtering함.
Large 버전은 ViT-L backbone을 사용하며 이미지에서 정확하고 세부적인 caption을 생성하는 데 강점이 있다.
- image captioning
- image-text retrieval
- VQA
에서 좋은 성능을 얻음.
❓ Backbone 이란?
\(\text{Image} \rightarrow \underbrace{\text{Backbone}}_{\text{Feature Extraction}} \rightarrow \underbrace{\text{Head}}_{\text{Task-specific Prediction}} \rightarrow \text{Output}\)
Backbone은 모델에서 입력 데이터의 핵심 특징(feature)을 뽑아내는 중심 신경망을 말함. 모델 전체에서 입력으로부터 범용적인 특징(feature)을 뽑아내는 핵심 본체.
예를 들어 고양이/강아지 분류 모델이라면,
\(\text{Image} \rightarrow \underbrace{\text{ResNet}}_{\text{Backbone}} \rightarrow \text{Feature} \rightarrow \underbrace{\text{Classifier}}_{\text{Head}} \rightarrow \text{Cat / Dog}\)
여기서 ResNet이 Backbone이고, 마지막 분류기 부분이 head(최종작업수행)임.
BLIP
\(\text{Image} \rightarrow \underbrace{\text{ViT-L}}_{\text{Backbone}} \rightarrow \text{Visual Features} \rightarrow \underbrace{\text{Text Decoder}}_{\text{Caption Generation}} \rightarrow \text{Caption}\)
5.3 GIT
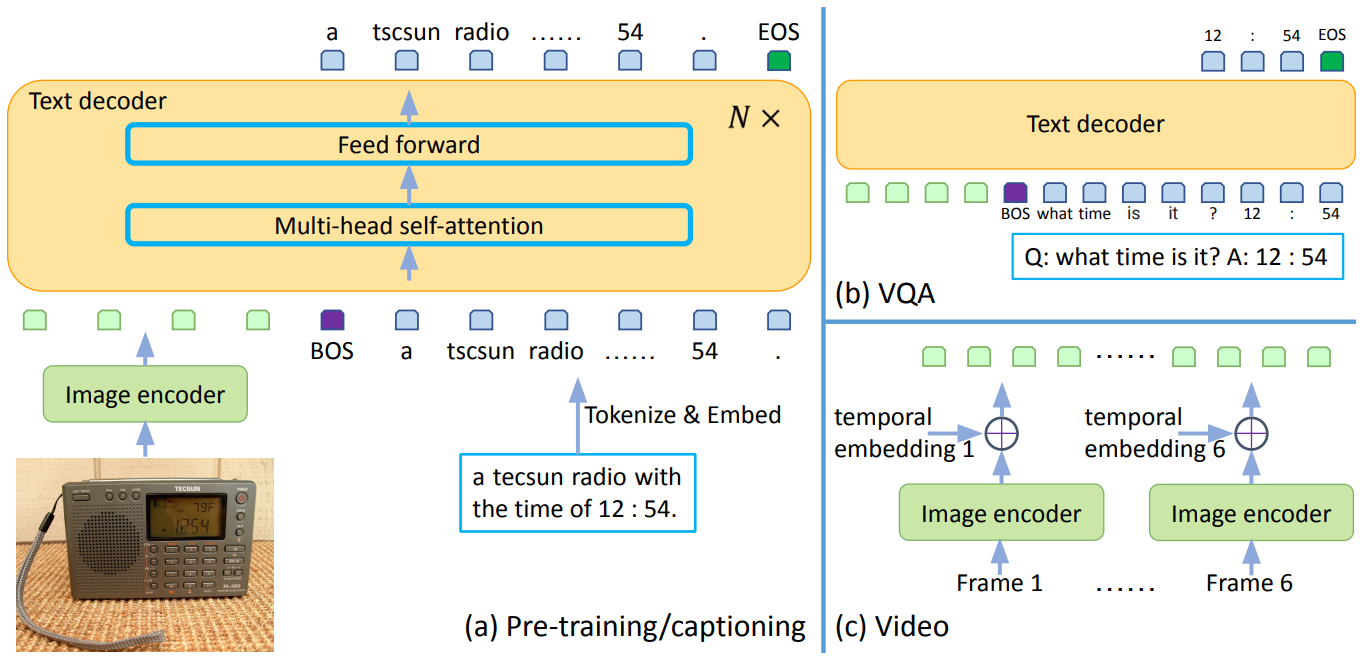
microsoft/git-base는 GIT(GenerativeImage2Text) 모델의 base 크기 버전이다.
Transformer decoder를 이용해 이미지에 대한 텍스트 설명을 생성.
이미지 token과 text token을 모두 입력으로 받고,
1
2
3
image 정보
+
이전에 생성한 text
를 기반으로 다음 text token을 예측.
- image captioning
- video captioning
등에서 사용할 수 있음.
6. Image-Text Retrieval
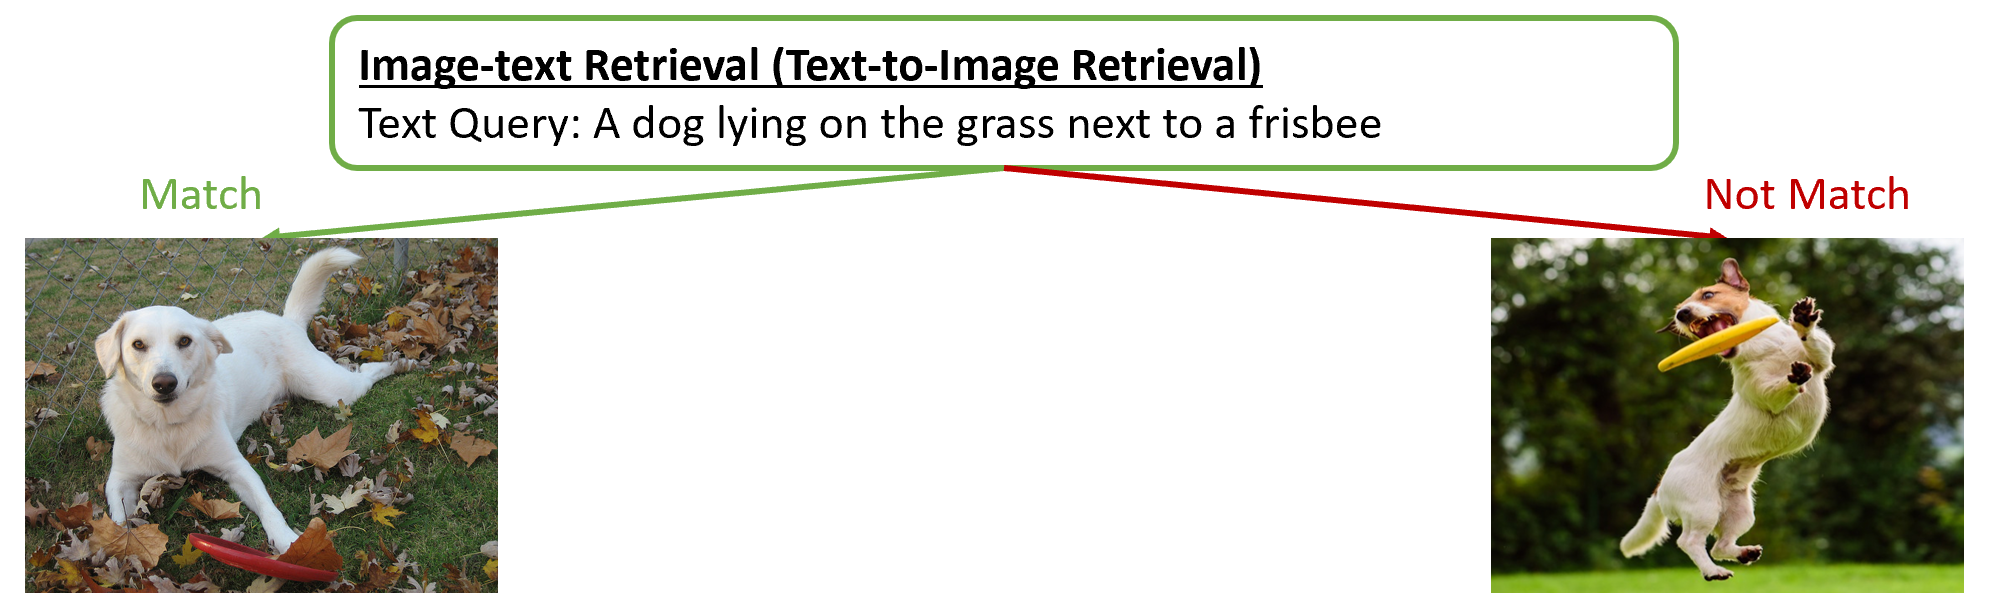
Image-Text Retrieval은 이미지와 텍스트를 같은 의미 공간에서 비교해서, 서로 가장 잘 맞는 이미지-텍스트 쌍을 찾아주는 검색 기술.
- Text-to-Image Retrieval: “A dog running on the grass” 같은 텍스트를 입력하면, 그 설명과 가장 잘 맞는 이미지를 검색
- Image-to-Text Retrieval: 이미지를 입력하면, 그 이미지를 가장 잘 설명하는 caption이나 텍스트를 검색
$\text{Image Captioning}$: Image → 새로운 문장 생성
$\text{Image-Text Retrieval}$: Image/Text → 기존 후보 중 가장 관련 있는 것 검색
Input
이미지와 자연어 텍스트(caption, description, keyword)
Output
텍스트가 query라면 그 텍스트와 가장 관련 있는 이미지를 순위 순으로 반환.
반대로 이미지가 query라면 이미지를 가장 잘 설명하는 텍스트들을 반환.
Task
Task 1: Image-to-Text Retrieval
Image → 적절한 caption 검색
Task 2: Text-to-Image Retrieval
“강아지가 잔디밭을 뛰어다니는 사진” → 적절한 이미지 검색
6.1 CLIP
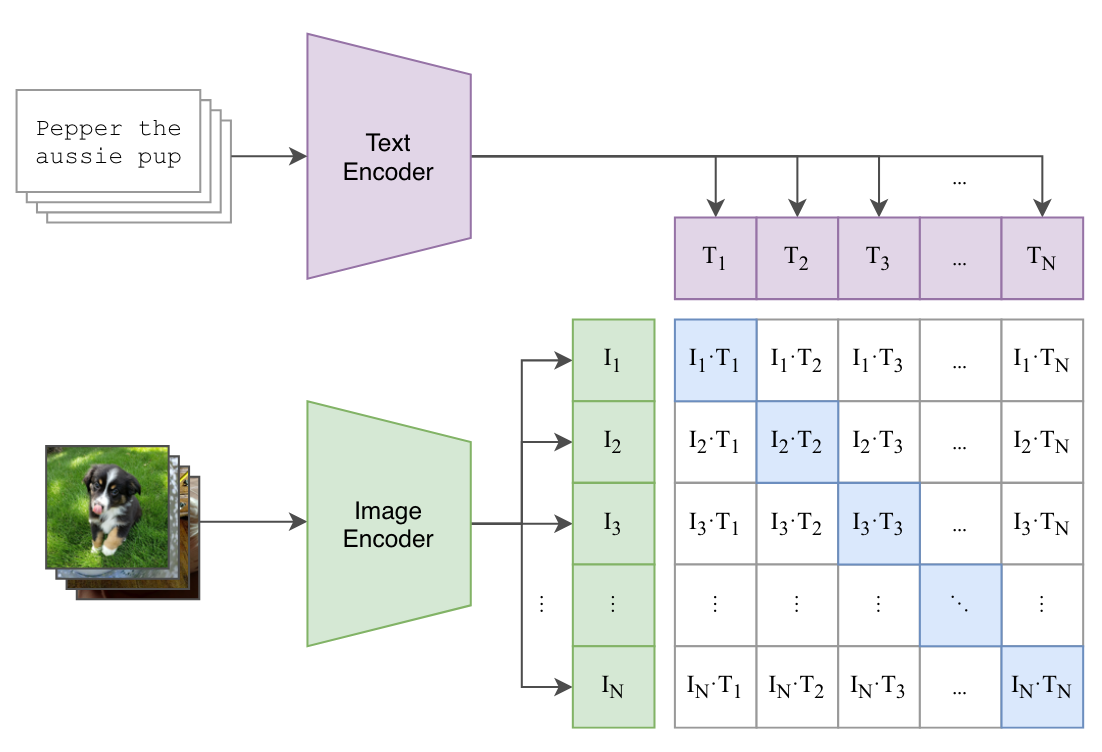
CLIP (Contrastive Language-Image Pre-training) 은 이미지와 텍스트를 각각 Encoder에 넣어 같은 embedding space에서 서로 의미가 얼마나 비슷한지 비교하도록 학습한 Vision-Language 모델
CLIP은 이미지와 텍스트를 하나의 shared embedding space에 표현함으로써 image-text retrieval에서 뛰어난 성능을 보임.
대규모 image-text 데이터에서 contrastive learning으로 pre-training되며, 서로 다른 개념을 동일한 공간에 표현할 수 있게 학습한다.
shared embedding space 이미지와 텍스트를 같은 벡터 공간에 표현하는 것
Contrastive Learning 의미가 맞는 이미지-텍스트 쌍은 가깝게, 의미가 안 맞는 쌍은 멀게 학습시키는 방식
7. Visual Grounding
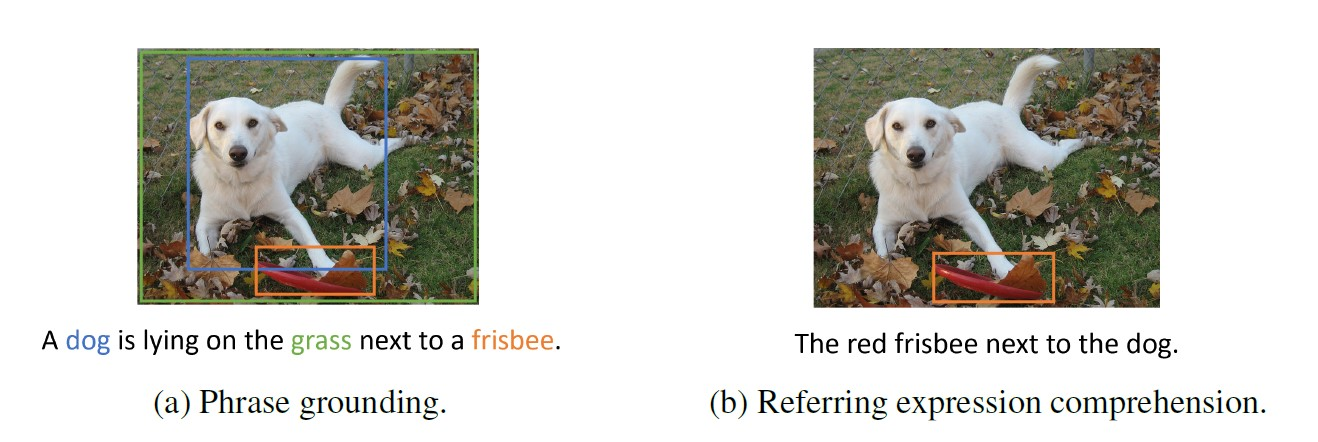
Visual Grounding: 자연어 표현이 이미지 속 어떤 객체나 영역을 가리키는지 찾아 연결하는 기술.
\(\text{Image} + \text{Text Query} \rightarrow \text{Object / Region Location}\)
일반적인 Object Detection은 정해진 class의 객체를 탐지하는 데 초점이 있다면, Visual Grounding은 “오른쪽에 앉아 있는 갈색 강아지” 처럼 자연어 표현을 조건으로 해당 객체를 찾는다.
Input
- Image: 객체나 장면이 포함된 이미지
- Natural Language Query: 이미지의 특정 객체나 영역을 가리키는 자연어 표현
Output
자연어가 가리키는 이미지 영역의 Bounding Box 또는 Segmentation Mask
Task
이미지의 시각적 정보와 query의 언어적 의미를 함께 이해하여
텍스트와 대응되는 객체의 위치를 찾는 것.
7.1 OWL-ViT
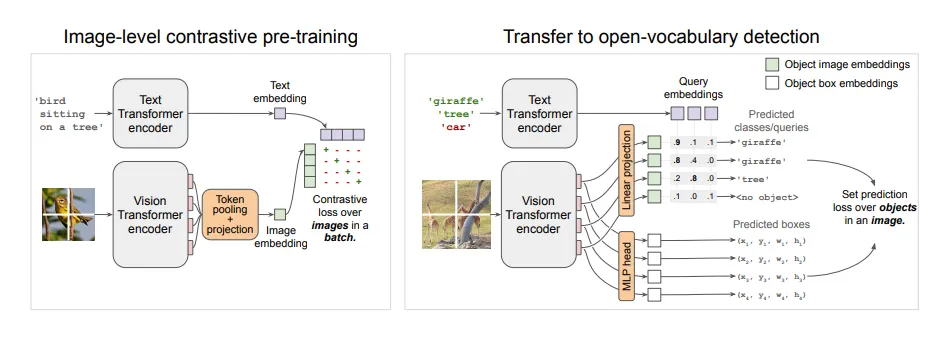
OWL-ViT (Vision Transformer for Open-World Localization)는
ViT를 기반으로 이미지와 텍스트를 함께 이용하여 객체를 탐지하는 모델.
가장 큰 특징은 Open-Vocabulary Object Detection이 가능하다는 점이다. (Open-Vocabulary Detection은 "red coffee mug" "yellow construction helmet" 같은 텍스트를 query로 입력할 수 있다.)
즉,
1
2
3
4
5
Image
+
"a photo of a cat"
↓
해당 객체의 Bounding Box
처럼 찾고 싶은 객체를 텍스트로 입력하여 이미지에서 해당 객체의 위치를 찾는다.
대규모 image-text pair를 이용한 contrastive pre-training과 fine-tuning을 통해 학습되며,
- Zero-shot: 텍스트를 이용해 객체 탐지
- One-shot: 하나의 이미지 예시를 이용해 비슷한 객체 탐지
가 가능함.
❓ Open-Vocabulary Detection 이란?
미리 정해놓은 class 목록에만 제한되지 않고,
사용자가 자연어로 입력한 새로운 객체 개념도 탐지할 수 있는 방식.
7.2 Grounding DINO
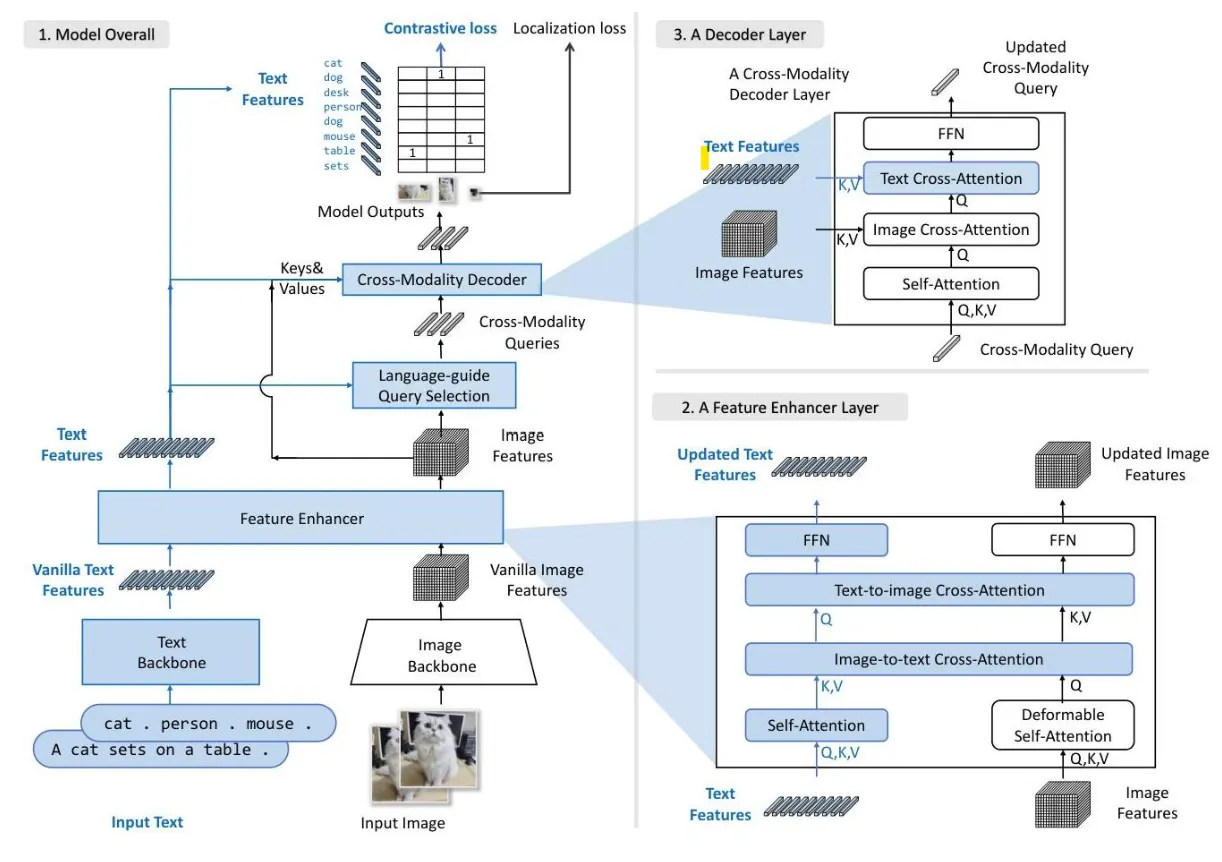
Grounding DINO는 Transformer 기반 Object Detector인 DINO에 텍스트와 이미지의 관계를 학습하는 grounded pre-training을 결합한 모델.
이미지뿐만 아니라 category name이나 자연어 description을 함께 입력받아
텍스트가 가리키는 객체를 Bounding Box로 탐지.
OWL-ViT
→ “이 이미지 영역이 cat이라는 텍스트와 얼마나 비슷한가?”
Grounding DINO
→ “이 문장이 가리키는 객체가 이미지에서 정확히 어디인가?”
| 구분 | OWL-ViT | Grounding DINO |
|---|---|---|
| 기본 구조 | ViT 기반 | DINO/DETR 기반 객체 탐지 모델 |
| 이미지 처리 | 이미지를 여러 patch로 나눠 특징을 뽑음 | 이미지에서 객체를 찾기 위한 특징을 뽑음 |
| 텍스트 처리 | 텍스트를 하나의 특징 벡터로 변환 | 텍스트의 단어/문장 정보를 특징으로 변환 |
| 핵심 방식 | 이미지 영역과 텍스트가 얼마나 비슷한지 비교 | 이미지와 텍스트 정보를 서로 주고받으며 함께 분석 |
| 객체를 찾는 방식 | 이미지의 각 영역을 텍스트와 비교해서 찾음 | 텍스트와 관련 있어 보이는 객체 후보를 먼저 고른 뒤 위치를 찾음 |
| 잘 맞는 입력 | "cat", "red car" 같은 짧은 단어·구 | "the red car next to the person" 같은 문장·긴 표현 |
| 특징 | 구조가 비교적 단순함 | 이미지와 텍스트 관계를 더 세밀하게 반영함 |
❓ Grounded Pre-training 이란?
이미지만 보고 객체를 학습하는 것이 아니라
이미지 속 객체와 자연어 표현의 관계까지 함께 학습하는 방식.
이를 통해 학습할 때 정해진 class에만 제한되지 않고 새로운 텍스트 표현을 이용한
Zero-shot Object Detection이 가능하다.
8. Text-to-Image Generation
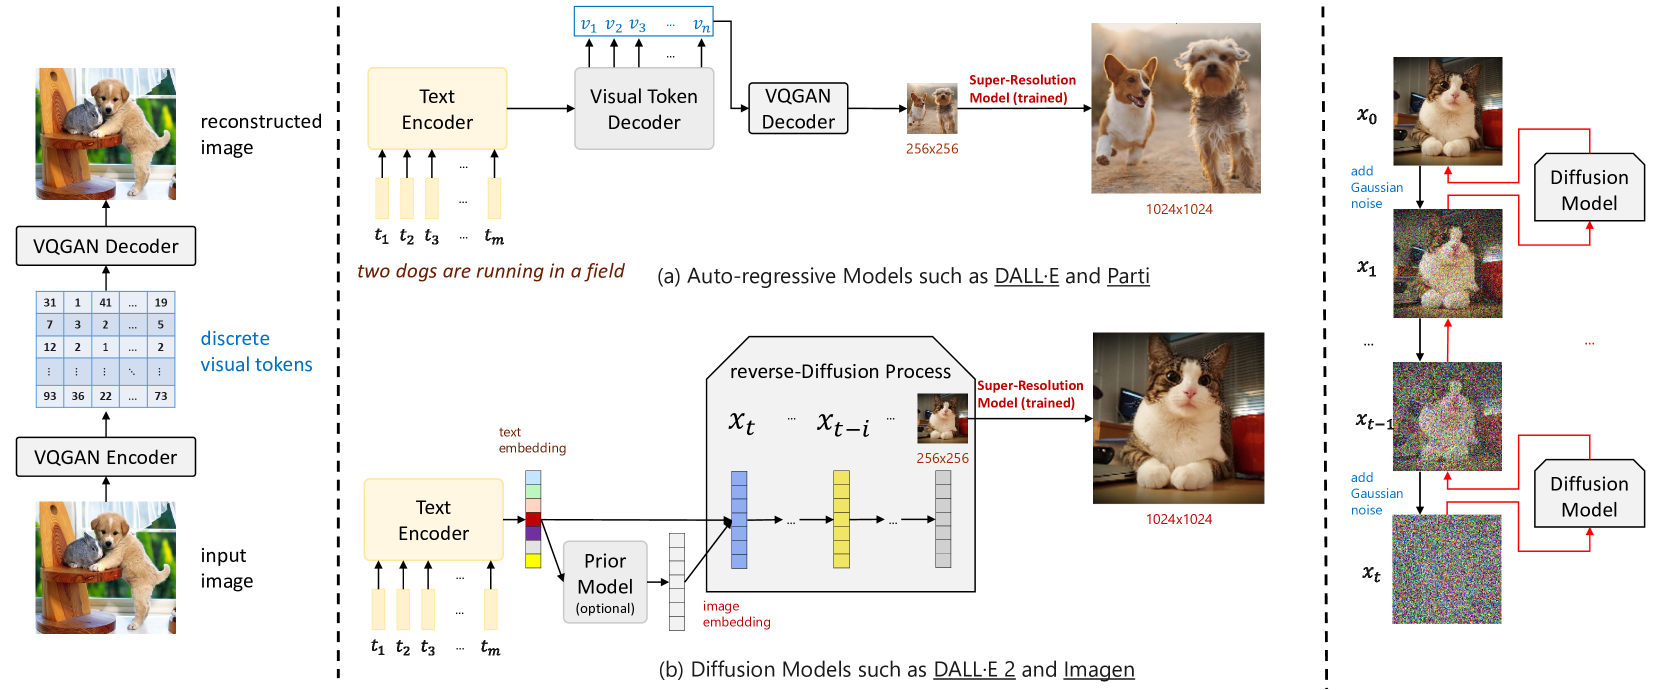
Text-to-Image Generation
사용자가 입력한 자연어 설명을 이해하여 그 내용과 대응하는 새로운 이미지를 생성하는 기술.
Input
자연어로 작성된 Text Prompt
Output
Prompt의 내용을 반영하여 새롭게 생성된 Image
Task
텍스트의 객체, 속성, 관계, 전체적인 의미를 이해하고
이를 시각적인 이미지로 생성하는 것.
Text-to-Image Generation의 대표적인 방식으로
- Auto-regressive Model
- Diffusion Model
이 있다.
8.1 Auto-regressive Models
Auto-regressive 방식은 이미지를 여러 개의 Image Token의 sequence로 표현하고,
언어 모델이 문장을 한 token씩 생성하듯 image token을 하나씩 순서대로 예측하여 이미지를 생성하는 방식.
예를 들어 텍스트가
"two dogs are running in a field" 라면 Text Encoder가 문장의 의미를 추출하고,
Decoder는 그 정보를 바탕으로
1
2
3
4
Image Token 1
→ Image Token 2
→ Image Token 3
→ ...
처럼 다음 image token을 계속 예측한다.
즉, 아래와 같이 이미지를 Transformer 가 처리할 수 있는 token 형태로 변환한다.
\[\text{Image} \rightarrow \text{VQ-VAE} \rightarrow \text{Image Tokens}\]❓ Image Token 이란?
이미지를 그대로 pixel 단위로 다루는 대신,
이미지의 시각적 특징을 표현하는 이산적인 token으로 변환한 것.
❓ VQ-VAE 이란?
이미지를 압축하여 discrete한 image token으로 변환할 수 있게 해주는 모델.
8.2 Stable Diffusion
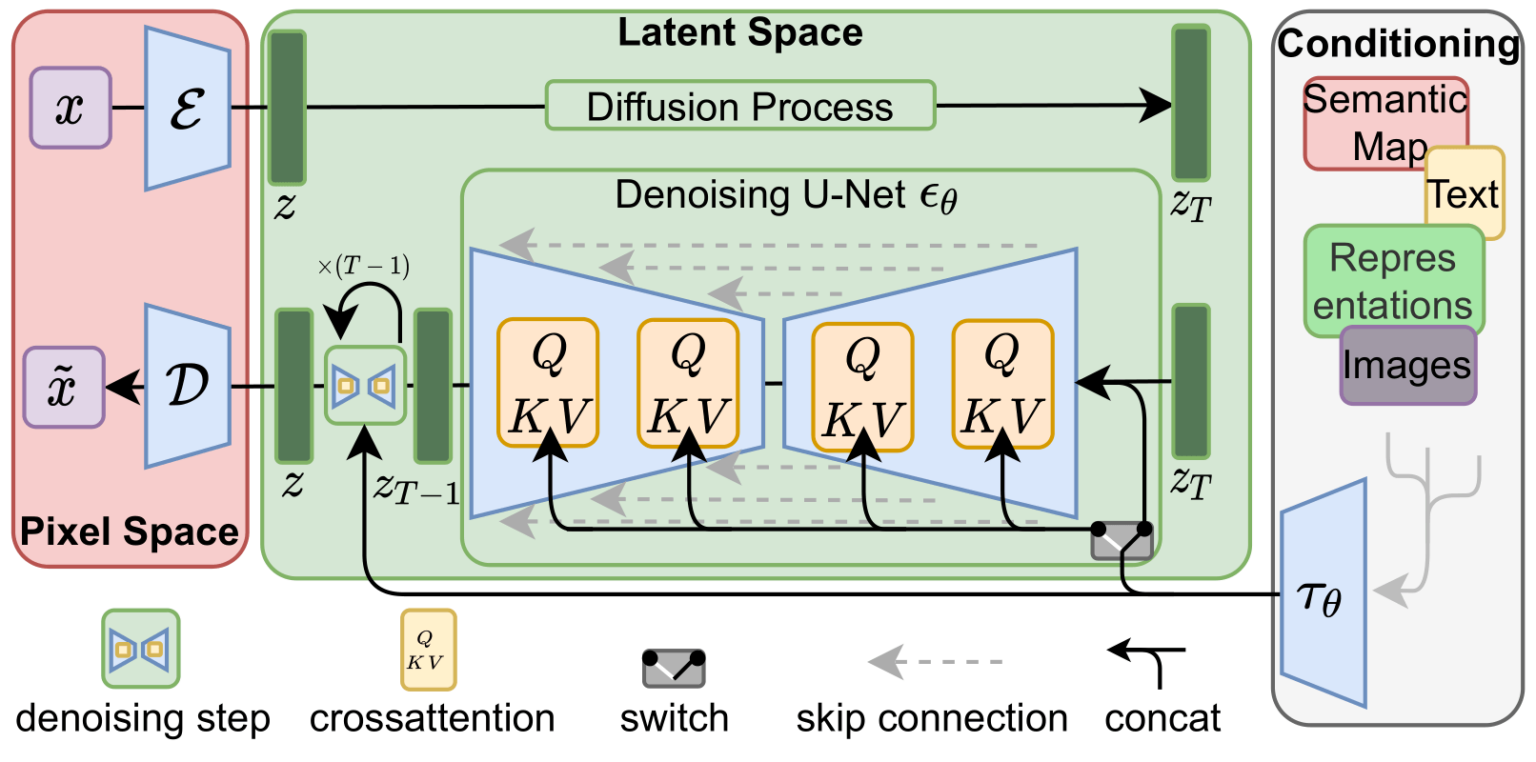
Stable Diffusion은 Text-to-Image Generation에 사용되는 대표적인 Diffusion Model.
완성된 이미지를 처음부터 바로 만드는 것이 아니라
random noise에서 시작하여 noise를 반복적으로 제거하면서 이미지를 생성한다.
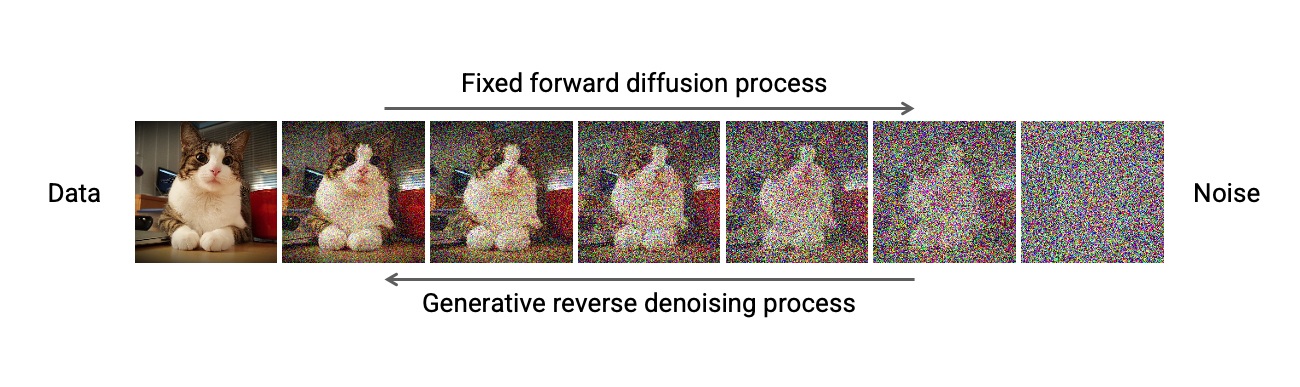
Random Noise
↓
Noise 제거
↓
Noise 제거
↓
Noise 제거
↓
Generated Image
이때 사용자의 Text Prompt를 함께 이용하여
어떤 방향으로 이미지를 생성해야 하는지 조건을 제공한다.
Stable Diffusion은 Latent Diffusion 방식을 사용한다.
즉 원본 pixel 공간에서 직접 diffusion을 수행하는 것이 아니라
이미지를 압축한 latent space에서 noise를 제거한다.
텍스트 쪽에서는 Frozen CLIP Text Encoder가 prompt를 embedding으로 변환하고,
U-Net은 이 텍스트 정보를 참고하면서 noise를 제거한다.
❓ Diffusion 이란?
이미지에 noise를 추가하는 과정을 반대로 학습하여,
random noise에서 noise를 조금씩 제거하면서 새로운 이미지를 생성하는 방식.
❓ Latent Diffusion 이란?
원본 이미지의 모든 pixel에서 diffusion을 수행하지 않고
압축된 latent space에서 diffusion을 수행하는 방식.
계산량과 memory 사용량을 줄일 수 있다.
9. Glimpse of Vision-Language Pretrained Models
일반적인 Vision-Language 모델의 전체 구조를 한 번 정리
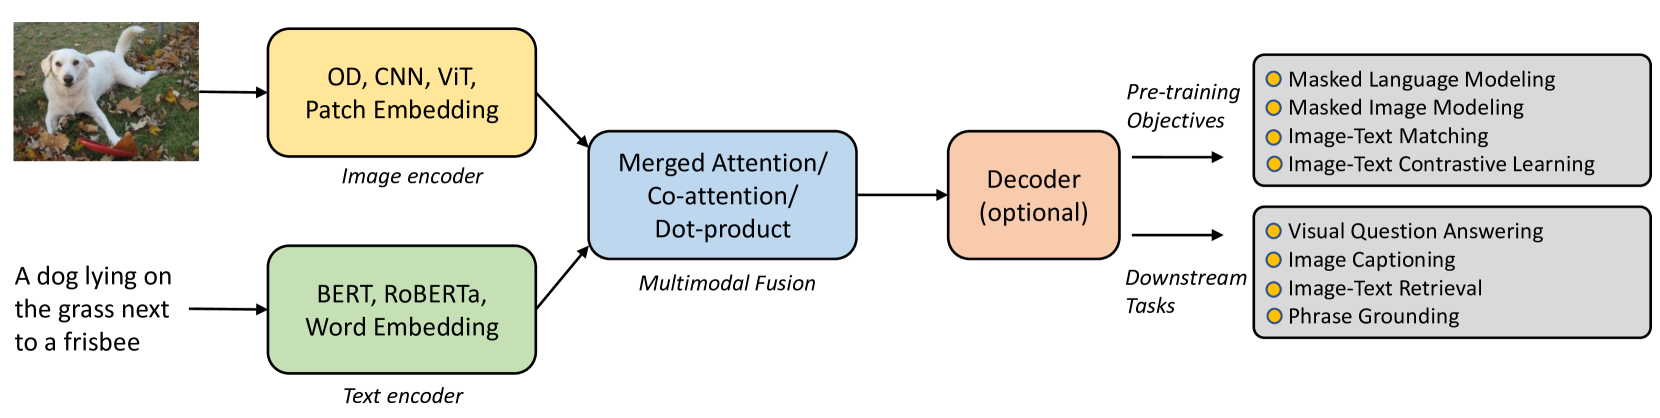
Vision-Language Pretrained Model(VLP)은 이미지와 텍스트를 함께 학습하여 두 modality의 정보를 연결해서 이해할 수 있도록 사전학습된 모델이다.
일반적인 Vision-Language Model의 전체적인 구조는 다음과 같다.
\[\text{Image} \rightarrow \text{Vision Encoder} \rightarrow \text{Visual Features}\] \[\text{Text} \rightarrow \text{Text Encoder} \rightarrow \text{Text Features}\]이렇게 얻은 두 feature를 Multimodal Fusion Module에서 결합한다.