[LAB] 261014 Lab Meeting
10/14 Lab Meeting
금일 랩미팅에서는 ViT, CLIP 논문 세미나 및 질의응답을 진행했다.
아래 내용은 랩미팅 내용과 이후 추가로 확인한 내용을 간단히 정리한 것이다.
Q&A
ViT
⭐️ Q(본인 질문). ViT는 왜 Pre-training에서는 Adam, Fine-tuning에서는 SGD + Momentum을 사용했을까? 경험적인 선택인가?
ViT 원 논문에서는
- Pre-training: Adam
- Fine-tuning: SGD + Momentum
을 사용한다.
결론부터 말하면 상당 부분 경험적인 training recipe에 가깝다.
Pre-training에서 Adam을 선택한 이유는 어느 정도 실험 근거가 있다. 저자들은 ResNet을 JFT에서 pre-training할 때 Adam과 SGD를 직접 비교했고, 평균 transfer 성능에서 Adam이 조금 더 좋았다. 그래서 ViT를 포함한 전체 pre-training에 Adam을 사용했다. 다만 ViT 자체에서 Adam vs SGD를 직접 비교한 ablation은 없다.
Adam이 대규모 pre-training에 적합했을 것으로 볼 수 있는 이유는 다음과 같다.
- parameter마다 gradient 크기에 맞춰 adaptive하게 update 크기를 조절
- Transformer처럼 큰 모델을 처음부터 학습할 때 optimization이 비교적 안정적
- 대규모 데이터와 많은 parameter를 학습하는 상황에 적합
반면 Fine-tuning에서는 논문이 왜 반드시 SGD + Momentum이어야 하는지에 대한 비교 실험이나 명확한 이론적 이유를 제시하지는 않는다. 그냥 모든 모델에 SGD + Momentum을 사용하고 learning rate 등을 튜닝했다.
추정할 수 있는 이유는, fine-tuning은 이미 좋은 representation을 학습한 모델을 downstream task에 맞게 작게 조정하는 단계이므로 단순한 SGD가 충분히 잘 작동할 수 있고, Momentum을 통해 noisy한 gradient를 누적하여 더 안정적으로 update할 수 있기 때문이다.
즉,
Pre-training의 Adam 선택은 일부 경험적 비교 결과가 있었고, Fine-tuning의 SGD + Momentum 선택은 당시 vision transfer learning에서 사용되던 실용적인 recipe에 더 가깝다.
또한 이것은 절대적인 규칙이 아니다. 후속 연구에서는 ViT fine-tuning에서도 AdamW가 SGD보다 더 좋은 경우가 보고되었으므로, optimizer는 결국 architecture와 task에 따라 실험적으로 선택해야 하는 hyperparameter라고 보는 것이 맞다.
Q(타학부생질문). 이미지를 patch sequence로 처리한다면 RNN도 가능할 텐데 왜 Transformer를 사용했을까?
RNN으로도 가능하지만 이미지에서는 Transformer가 더 적합하다.
- RNN은 patch를 순차적으로 계산해야 해서 병렬화가 어렵다.
- 멀리 떨어진 patch의 정보가 여러 hidden state를 거쳐 전달된다.
- 이미지 patch에는 자연어처럼 명확한 1차원 순서가 존재하지 않는다.
- Self-Attention은 모든 patch 사이의 관계를 직접 계산할 수 있다.
즉 ViT의 핵심은 단순히 이미지를 sequence로 만드는 것이 아니라,
Self-Attention으로 이미지 전체의 global relationship을 학습하는 것
이다.
Q(타학부생질문). Figure 7에서 왜 같은 행·열의 positional embedding이 비슷하게 학습될까?
ViT는 각 patch 위치에 learnable positional embedding을 사용한다.
처음부터 2D 구조를 명시적으로 넣은 것은 아니지만, 모든 이미지에서 동일한 sequence position은 항상 동일한 이미지 위치를 담당한다.
학습이 진행되면서 모델이 이미지의 공간적 관계를 학습하고, 결과적으로 positional embedding에서도
- 가까운 위치
- 같은 row
- 같은 column
사이의 유사성이 나타난다.
즉,
명시적인 2D positional rule 없이도 이미지의 2D spatial structure가 학습되었다는 의미
이다.
CLIP
⭐️ Q(본인질문). Contrastive Learning에서 실제로 의미가 같은 pair가 negative로 처리될 수도 있지 않은가?
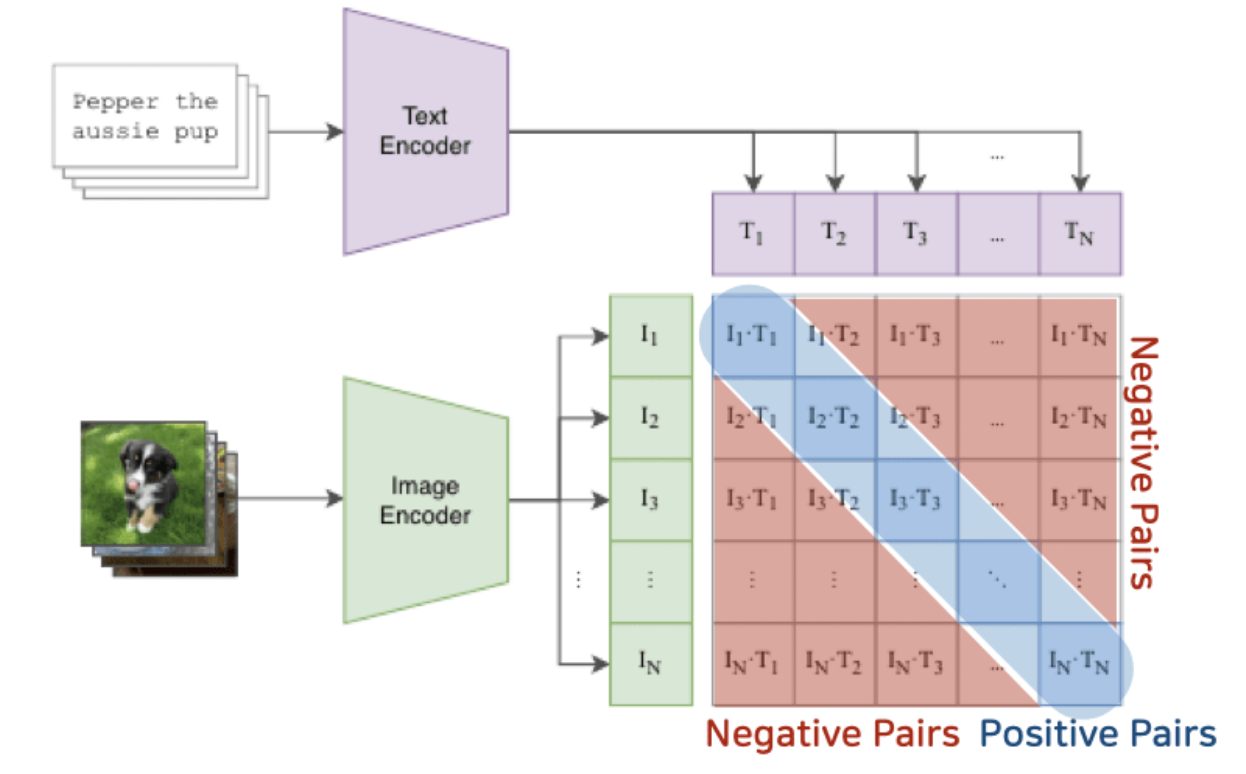
가능하다.
예를 들어 서로 다른 image-text pair라도 둘 다 같은 종류의 강아지를 설명한다면 의미상으로는 유사할 수 있다.
하지만 CLIP에서는 같은 batch의 정답 pair가 아니면 negative로 처리된다.
이를 False Negative 문제라고 한다.
후속 연구에서는
- 여러 positive를 허용하거나
- 의미적으로 비슷한 negative를 제거하거나
- negative에 서로 다른 weight를 주는 방식
등으로 이 문제를 완화한다.
⭐️ 즉 “4억 장이라 같은 의미가 한 batch에 들어올 확률이 낮아서”라기보다는, 일부 false negative가 존재하더라도 대규모·다양한 데이터에서 얻는 positive/negative signal이 이를 압도했다고 보는 것이 더 정확하다.
다만 false negative 자체는 실제 Contrastive Learning의 한계이며, 이후 연구에서는 false negative 제거, multiple positive 지정, re-weighting 등의 방식으로 이를 완화한다.
핵심 개념 정리
Inductive Bias
모델이 데이터를 보기 전부터 구조적으로 가지고 있는 사전 가정.
CNN에는 대표적으로 다음 inductive bias가 있다.
- Locality
- Weight Sharing
- Translation Equivariance
ViT는 CNN보다 이미지에 특화된 inductive bias가 약하다.
따라서 적은 데이터에서는 CNN이 유리할 수 있지만, 데이터가 충분히 커지면 ViT가 이러한 관계를 직접 학습할 수 있다.
핵심 질문:
사전지식을 모델 구조에 넣을 것인가, 아니면 데이터를 통해 학습하게 할 것인가?
Invariance vs. Equivariance
Equivariance
입력의 위치가 변하면 feature도 그만큼 같이 변한다.
1
2
이미지 이동
→ feature map의 activation도 이동
CNN의 convolution이 대표적인 예다.
Invariance
입력의 위치가 변해도 최종 prediction은 유지된다.
1
2
3
고양이가 왼쪽에 있음
고양이가 오른쪽에 있음
→ 둘 다 "cat"
CNN에서는 전체적으로
Convolution → Equivariance
후반부 representation / Classification → Invariance
방향으로 간다고 이해할 수 있다.
CLIP 핵심 정리
Contrastive Learning
CLIP의 기본 아이디어:
정답 image-text pair는 가까워지게 하고,
관계없는 pair는 멀어지게 한다.
예를 들어 batch가 4라면
1
2
3
4
image1 ↔ text1
image2 ↔ text2
image3 ↔ text3
image4 ↔ text4
총 16개의 조합 중 대각선의 4개가 positive pair이다.
이를 통해 image와 text를 같은 embedding space에 정렬한다.
Symmetric Loss
CLIP은 두 방향으로 loss를 계산한다.
- Image → Text: 이 이미지와 대응되는 text 찾기
- Text → Image: 이 text와 대응되는 image 찾기
즉,
Image-to-Text Loss + Text-to-Image Loss
를 함께 사용하는 것이 Symmetric Contrastive Loss이다.
Zero-shot Classification
기존 classification 모델은
1
2
3
4
dog
cat
car
...
처럼 미리 정해진 class에 대해 classifier를 학습한다.
반면 CLIP은 class 이름 자체를 text encoder에 넣는다.
1
2
3
4
5
"a photo of a dog"
        ↓
Text Encoder
        ↓
Text Embedding
이후 image embedding과 similarity를 비교한다.
따라서 학습 당시 별도의 classifier에 존재하지 않던 새로운 class도 text로 표현할 수 있어 zero-shot classification이 가능하다.
Prompt Engineering
CLIP은 image-caption pair로 pre-training되었다.
즉 text encoder는 단순한 class label만 본 것이 아니라, 이미지와 함께 등장하는 caption 형태의 문장을 지속적으로 학습했다.
그래서 zero-shot classification에서도
1
dog
처럼 class name만 넣는 것보다
1
a photo of a dog
처럼 학습 당시의 caption 분포와 비슷한 형식으로 넣었을 때 더 잘 작동할 수 있다.
즉 핵심은
CLIP이 image-caption 형태로 학습되었기 때문에, 추론 시에도 text prompt가 pre-training 때 보았던 caption 형식에 가까울수록 더 적절한 text representation을 만들 가능성이 높다.
따라서 "a photo of a ..." 같은 prompt는 단순한 문장 꾸미기가 아니라, pre-training data distribution에 맞춰 입력 형식을 조정하는 것으로 볼 수 있다.
Retrieval
CLIP embedding은 검색에도 사용할 수 있다.
Image Retrieval
1
2
3
Image
→ Image Encoder
→ 유사한 image embedding 검색
Cross-modal Retrieval
1
2
Text → Image
Image → Text
CLIP이 image와 text를 같은 embedding space에 정렬했기 때문에 가능한 활용이다.
발표 피드백
논문 발표에서는 대본을 읽는 것과 내용을 설명하는 것의 차이를 의식할 필요가 있다.
- 대본을 그대로 읽지 않고 본인의 언어로 설명 (결국 하나의 청중 앞에서 하는 acting 이라, 대본만 외워서 하는 발표는 청중이 집중하기가 어렵다는 것)
결국 논문을 이해하는 것과 이해한 내용을 전달하는 것은 별개의 능력이다 라는 것.