[Paper] LoRA: Low-Rank Adaptation of Large Language Models
Introduction
LoRA는 거대 인공지능 모델의 전체 가중치를 수정하는 대신, 적은 수의 추가 파라미터만 학습시켜 비용과 시간을 크게 줄이는 고효율 파인튜닝 기법이다.
Model Size가 커졌고, 대형언어모델은 GPU에 올리는 것조차 쉽지 않음.
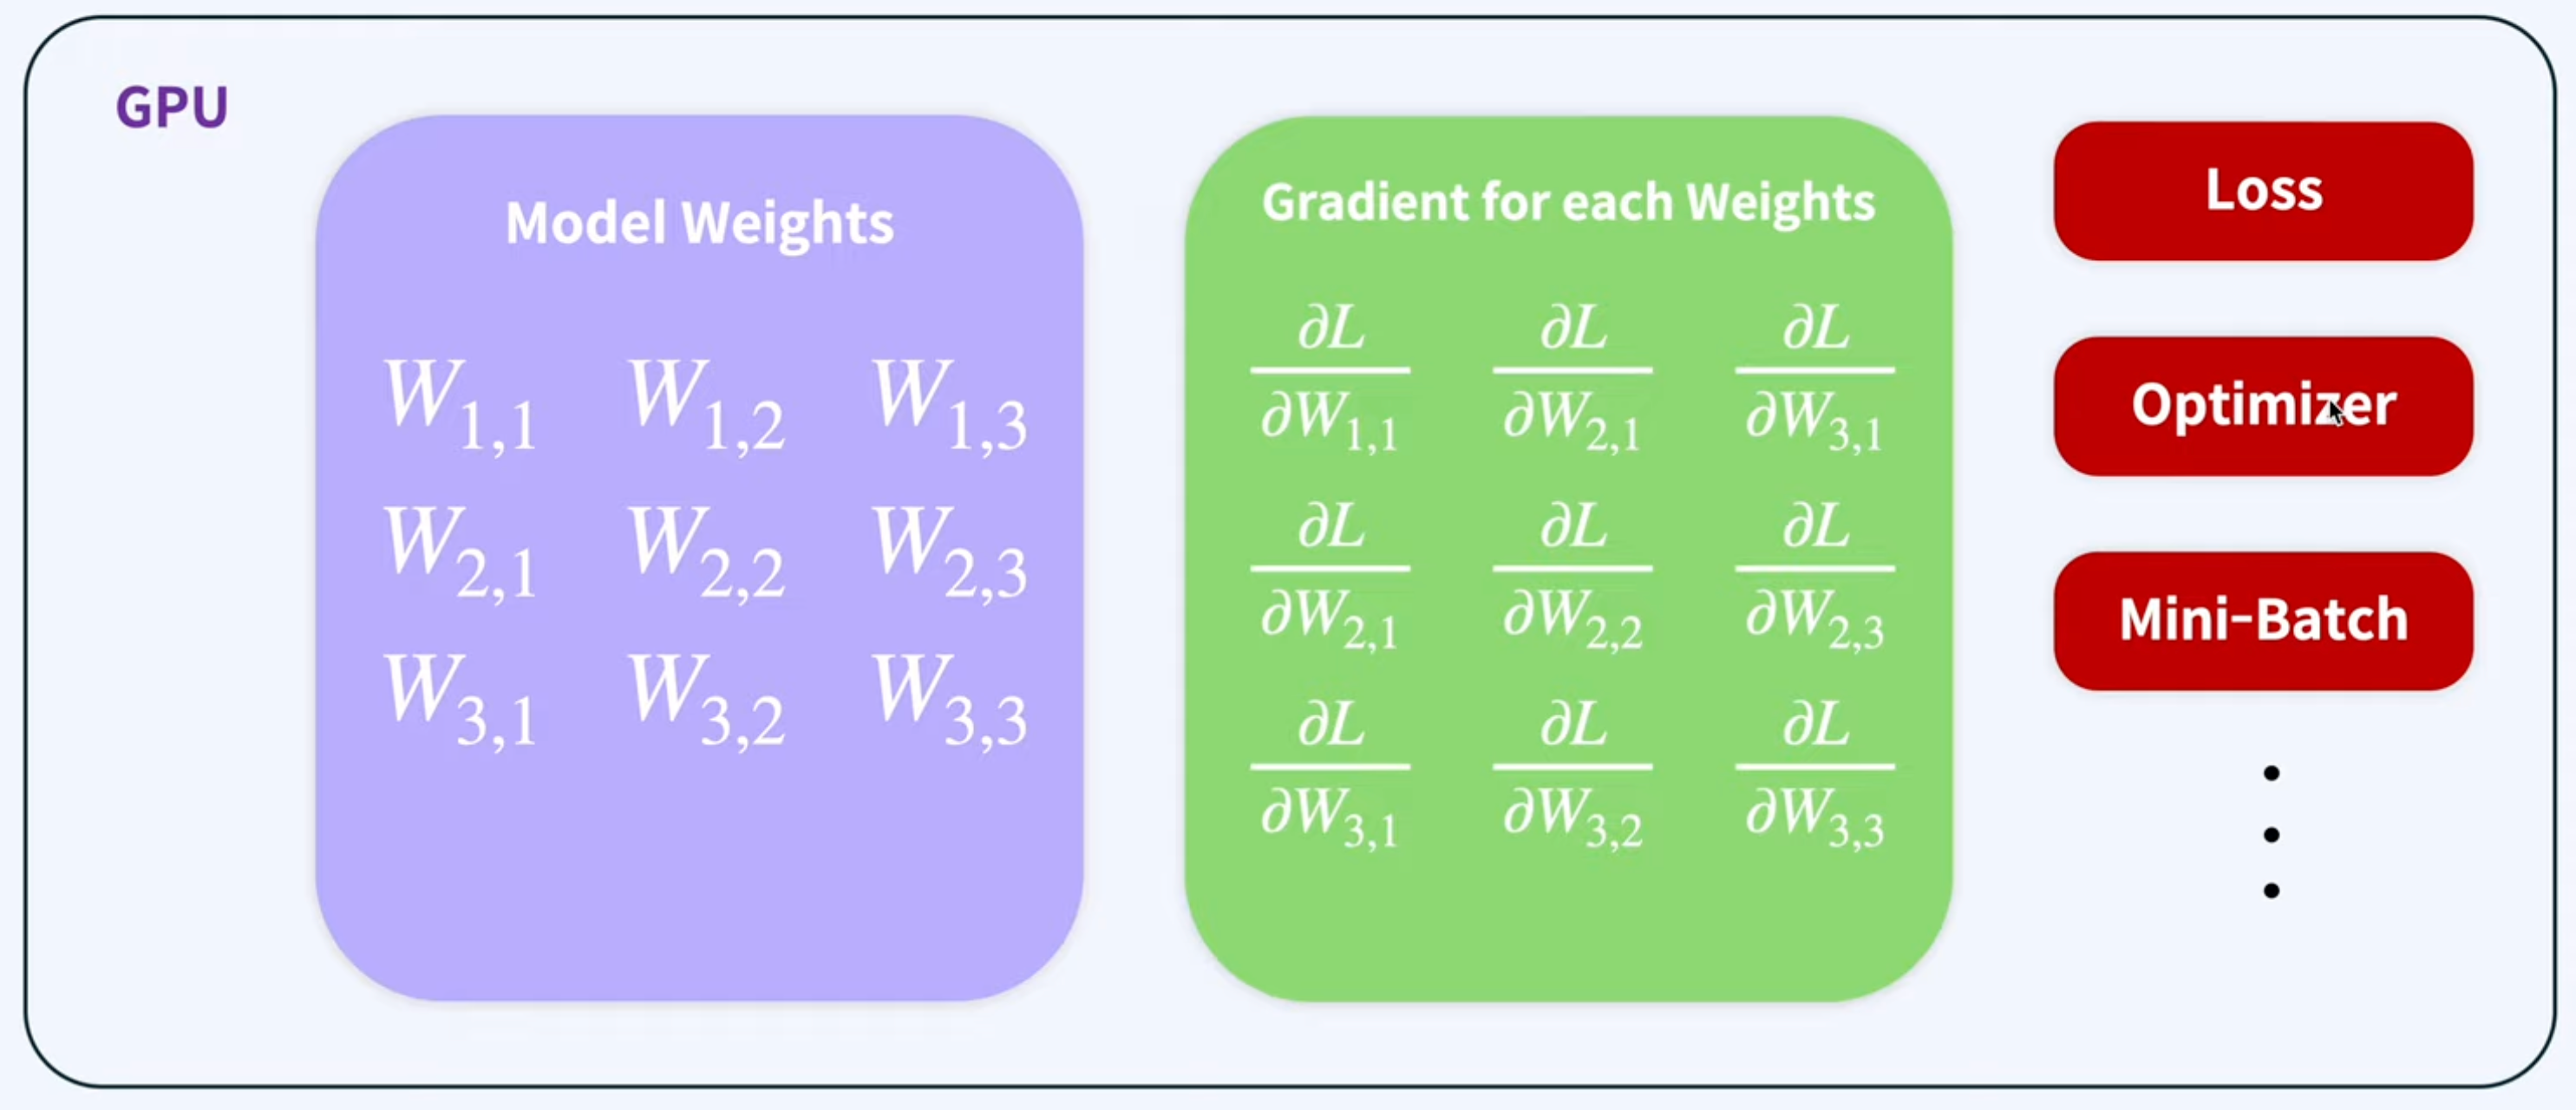
Model Weights 뿐만 아니라 Model Weights를 훈련하는 모든 파라미터에 대해서 미분값도 함께 저장하게 됨. Loss Optimizer Mini-Batch 등 추가적으로 저장해야하는 것들도 많음.
즉, Fine-tuning 할 때 GPU에 많은 자원을 올려야함.
Main Goal
대규모 사전학습 모델의 weight는 고정하고, task adaptation에 필요한 weight update만 low-rank 형태로 학습하여 Fine-tuning 비용을 줄이는 것.
Motivation: Limitations of Full Fine-Tuning
- 사전학습된 모델의 (일반화)성능을 떨어뜨릴 수 있음.
- large scale의 labeled data가 필요함.
- High optimization complexity and time-consuming
Existing Parameter-Efficient Fine-Tuning Methods
Adapter Layers
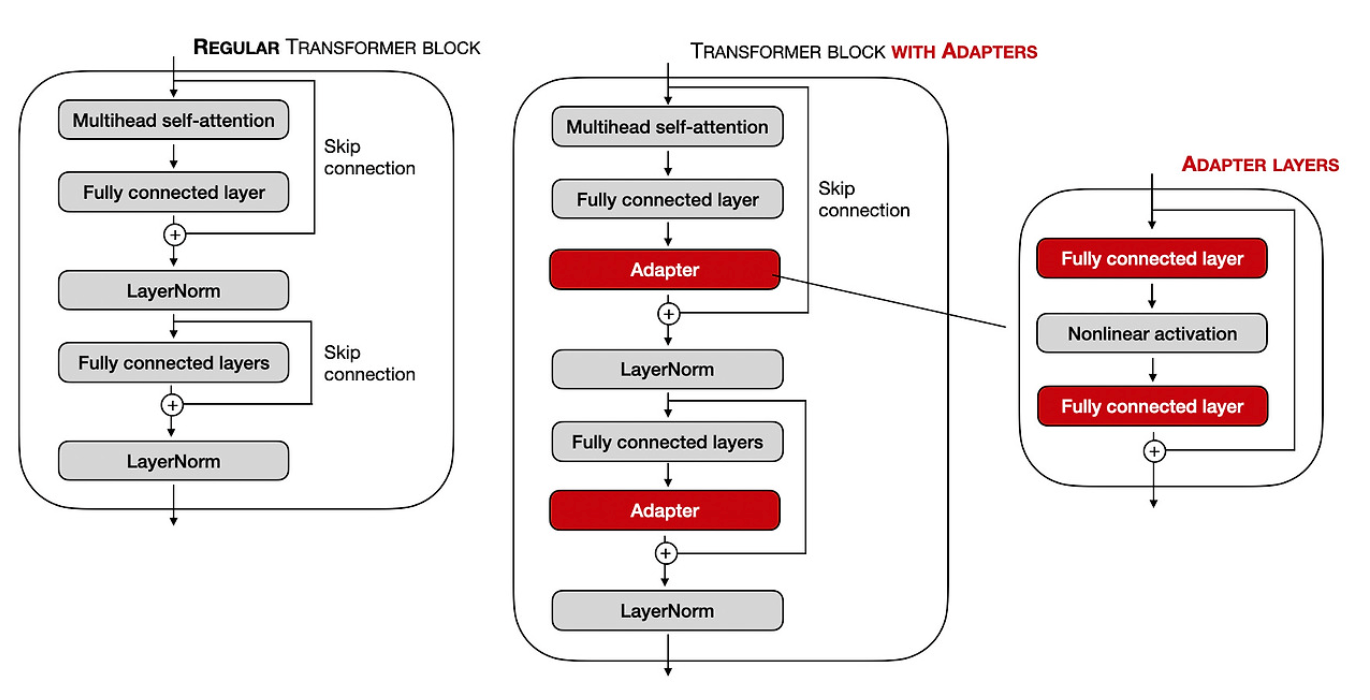
큰 모델의 기존 파라미터는 거의 그대로 두고, 중간중간에 작은 학습용 모듈(Adapter)을 추가해서 그것만 학습하는 방식
Adapter 자체는 보통 이런 작은 bottleneck 구조임.
$h$ → $W_{\text{down}}$ → $활성화함수$ → $W_{\text{up}}$ → $h$
(Bottleneck: 인공신경망에서 데이터의 차원(채널)을 강제로 줄였다가 다시 늘리는 계층(Layer)을 의미함.)
학습할 때는 원래 Transformer의 수억~수십억 개 파라미터를 freeze하고, 이 작은 Adapter 파라미터만 업데이트함.
Modern GPU 에서는 효율(속도)가 좋지 않음.
학습하는 파라미터는 적어지지만, inference 때도 이 Adapter를 계속 통과해야 함. 즉 연산 단계가 추가됨. (모델의 깊이를 확장하여 inference latency를 도입함)
Prefix Tuning
혹은 이와 다르게 모델의 사용 가능한 시퀀스 길이를 줄이는 방법도 존재한다. (prefix tuning)
위와 같은 기존 PEFT는 저장공간은 아꼈지만 Adapter는 느려지고, Prefix는 context를 잡아먹고, Full Fine-Tuning보다 성능도 낮았다. 파라미터는 훨씬 적게 학습하지만, 성능이 떨어진다는 trade-off 가 존재.
Method
LoRA가 어떻게 Adapter처럼 시간복잡도(연산량)을 늘리지 않으면서도 효과적으로 fine-tuning 할 수 있게끔 만들었는지 알아보자.
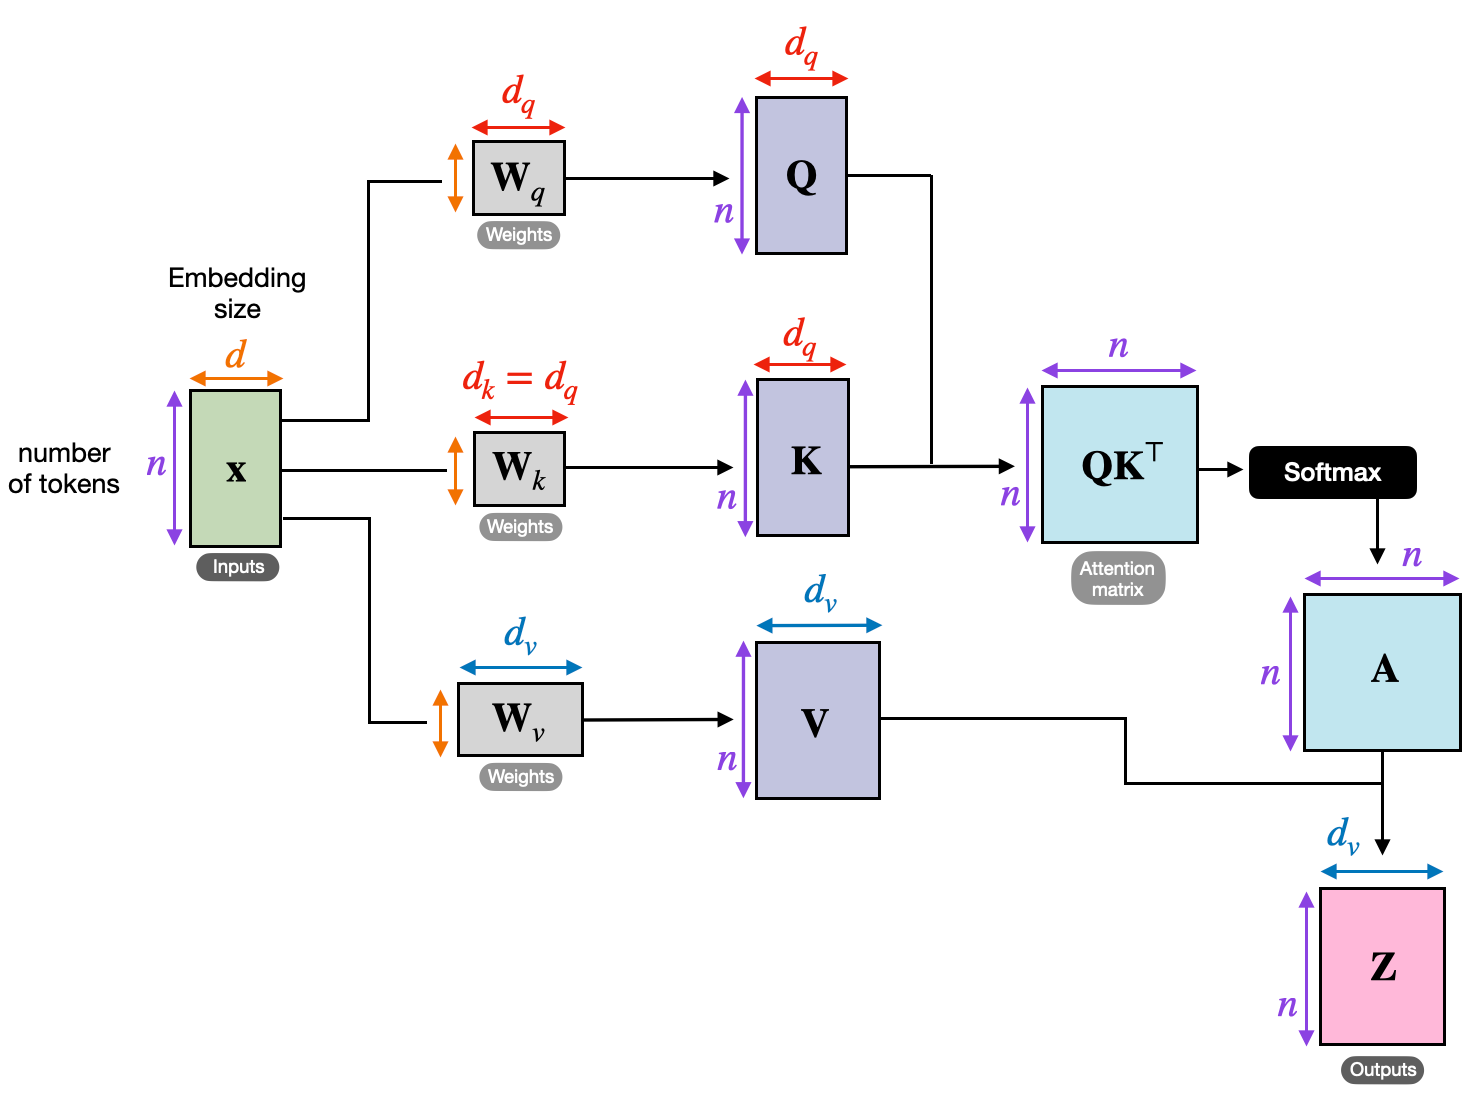
Problem Formulation
$Φ$로 parameterize된 사전 학습된 autoregressive model $P_Φ(y|x)$ 가 주어졌다고 가정
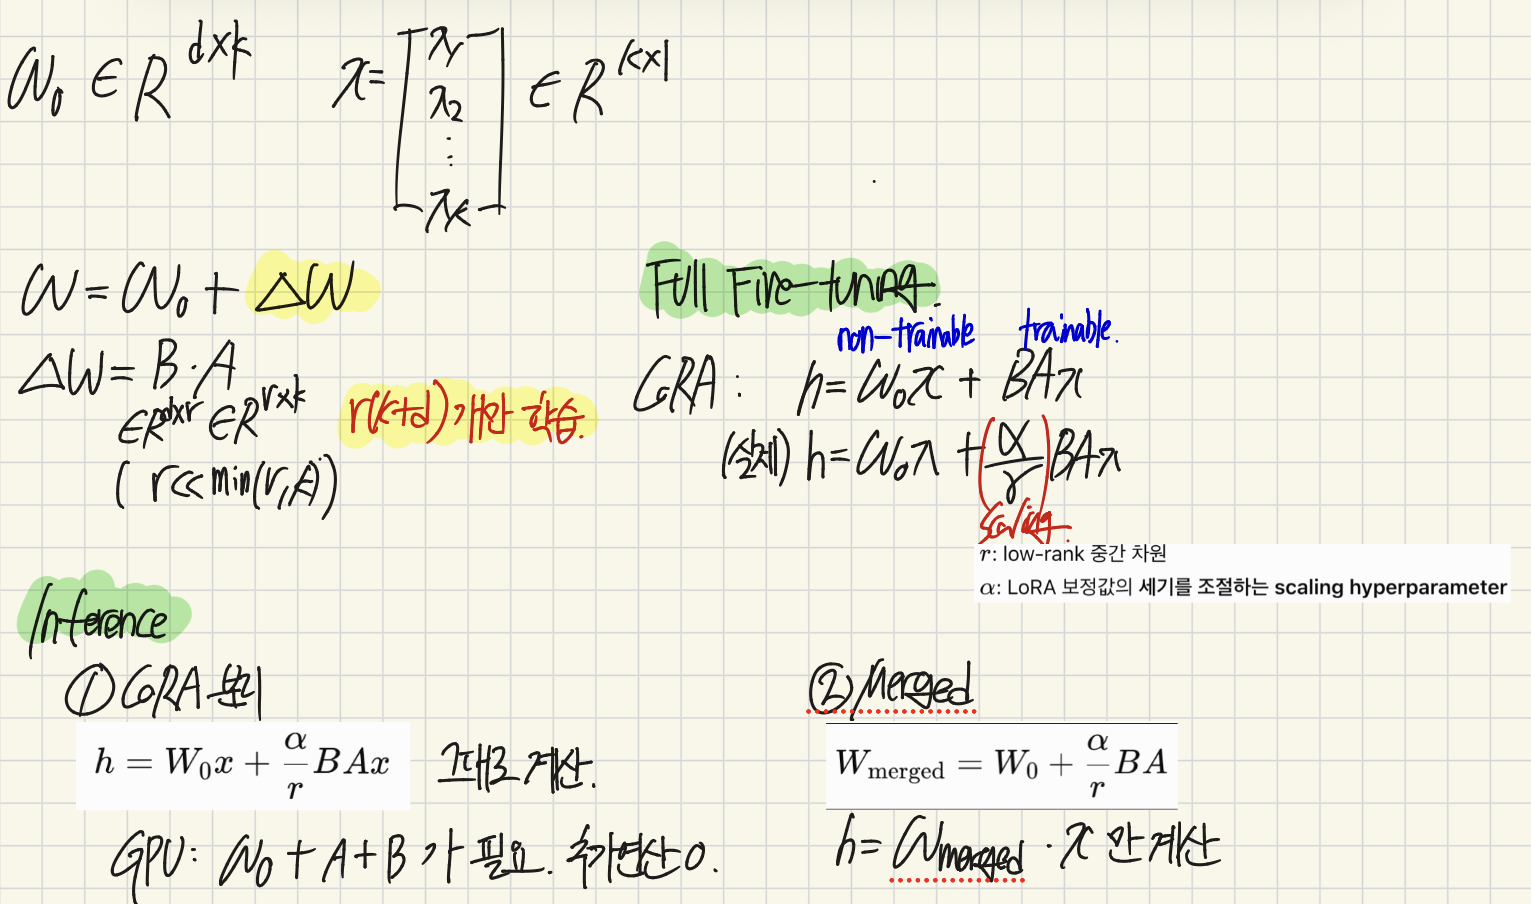
LoRA는 $W_q,W_k,W_v,W_o$와 같은 기존 weight를 freeze하고, 해당 weight에 더해질 low-rank update $\Delta W=BA$ 만 최적화한다.
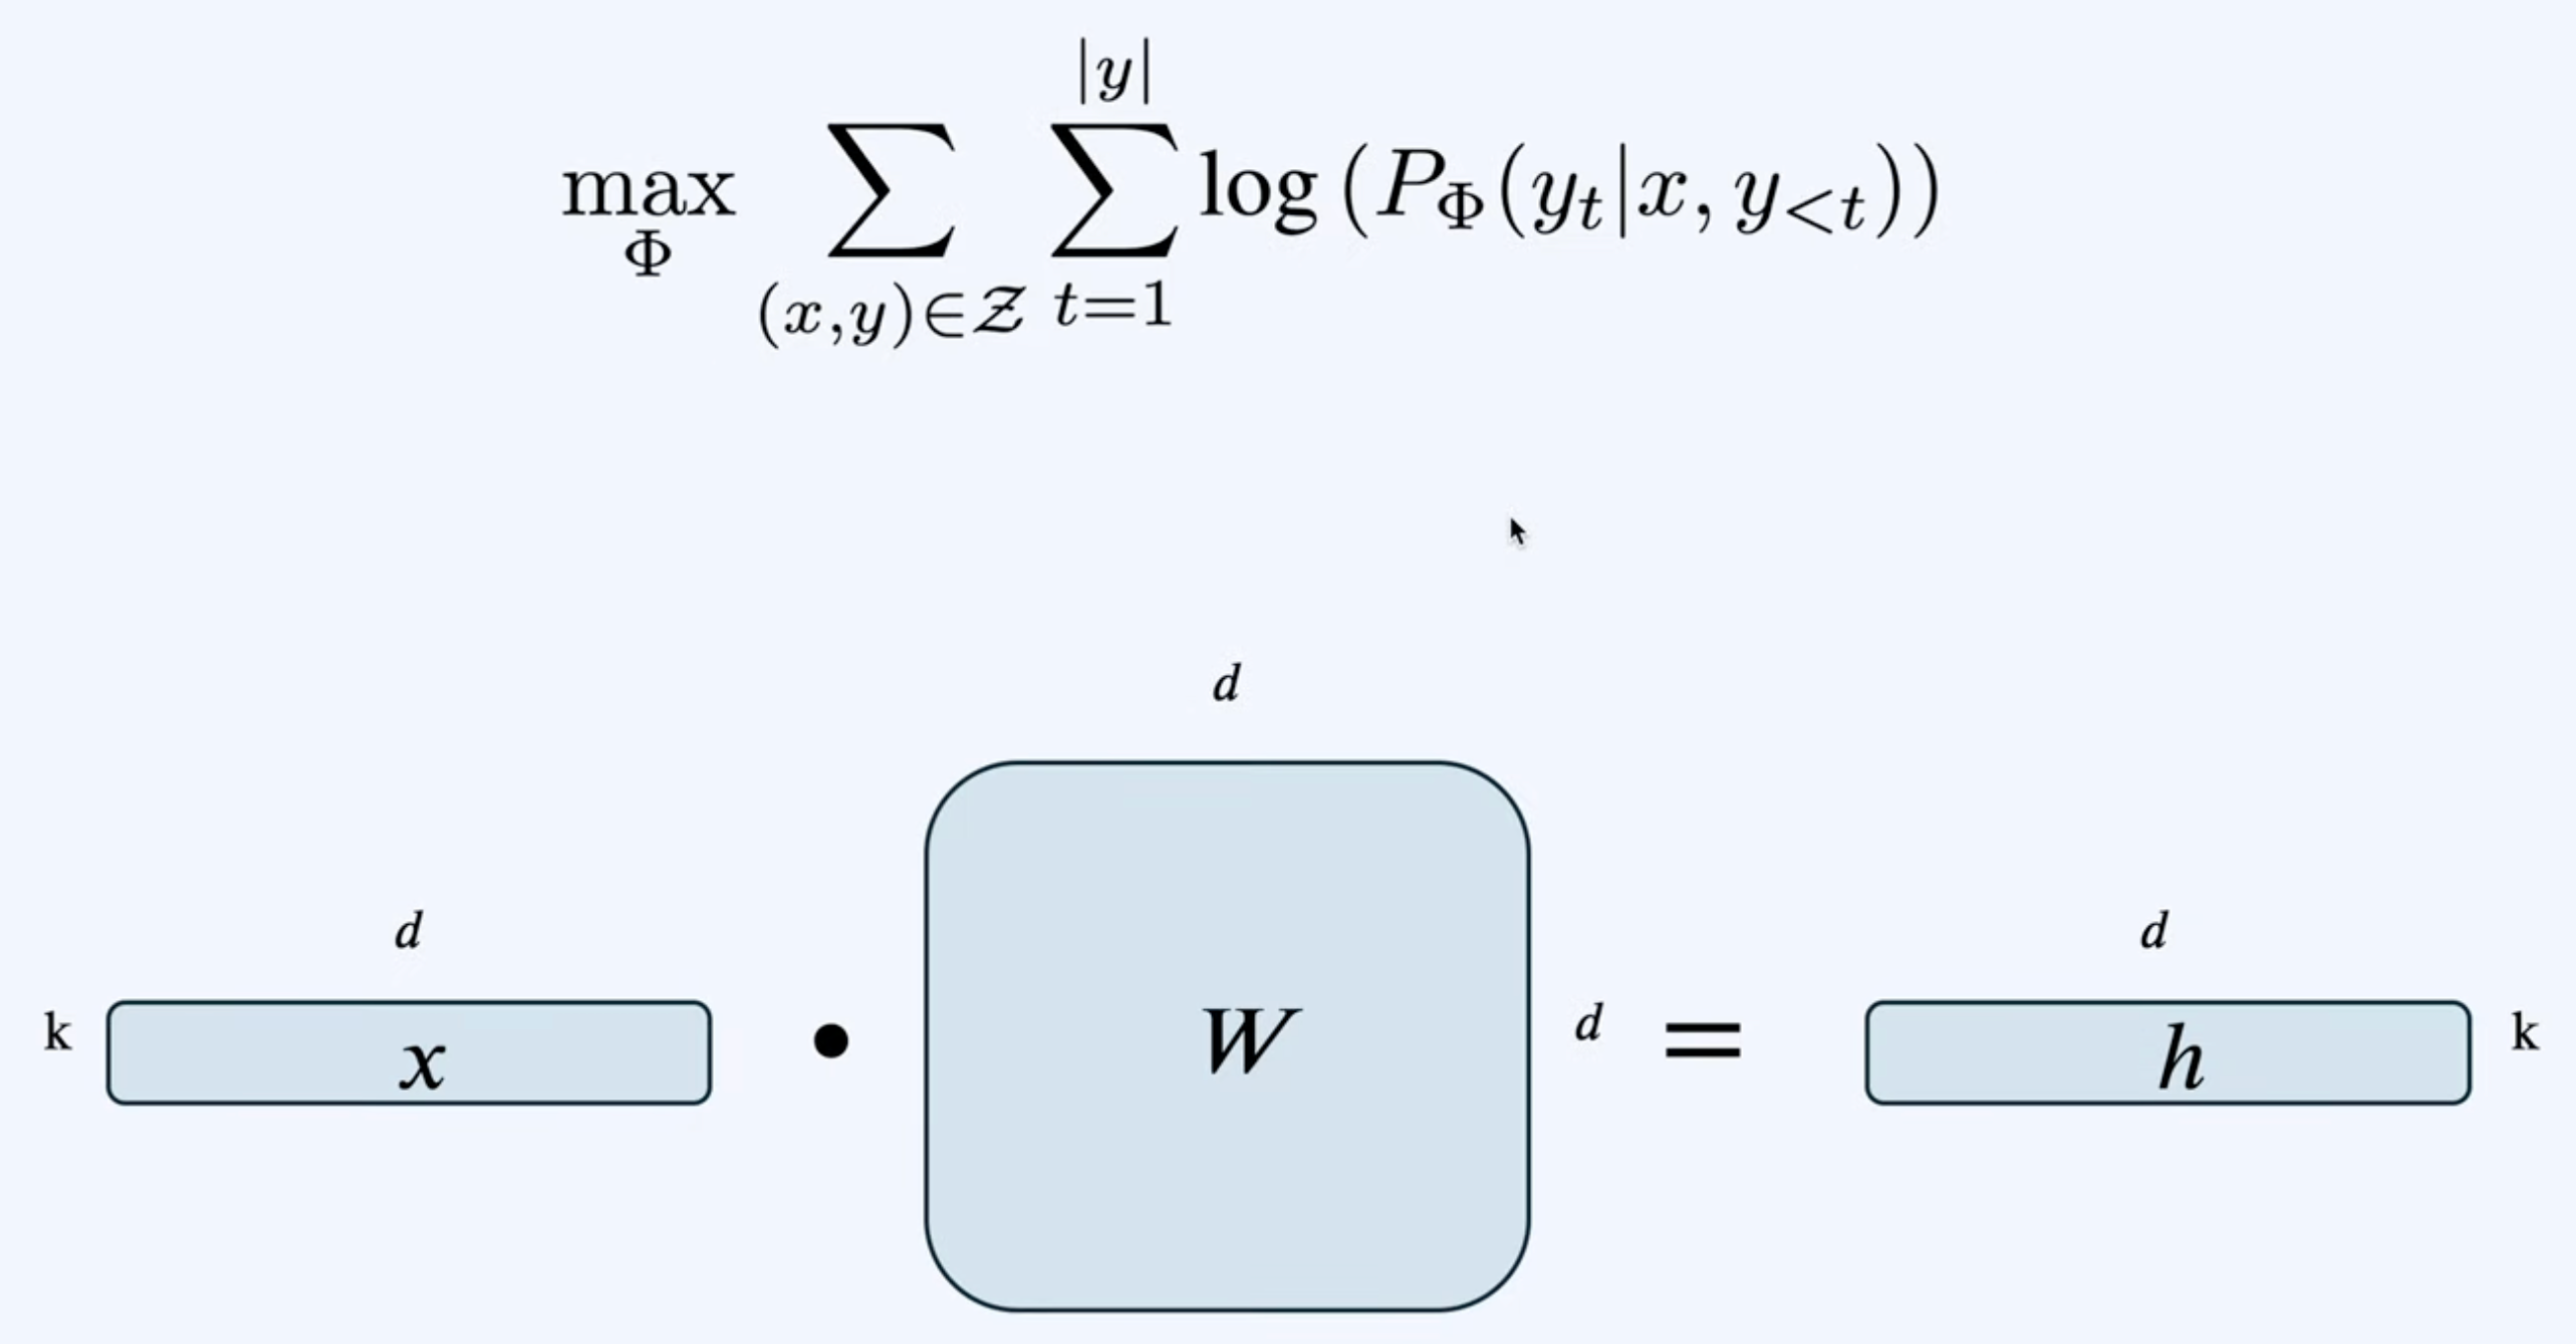
언어 모델의 학습 목적함수, 정확히는 Maximum Likelihood Objective 임.
$Φ$는 모델 전체 파라미터이고, $W$는 그 안에 들어있는 여러 weight matrix 중 하나임.
입력 $x$ 와 이전 토큰들을 보고 다음 정답 토큰을 높은 확률로 맞히도록 모델을 학습하는 식이다.
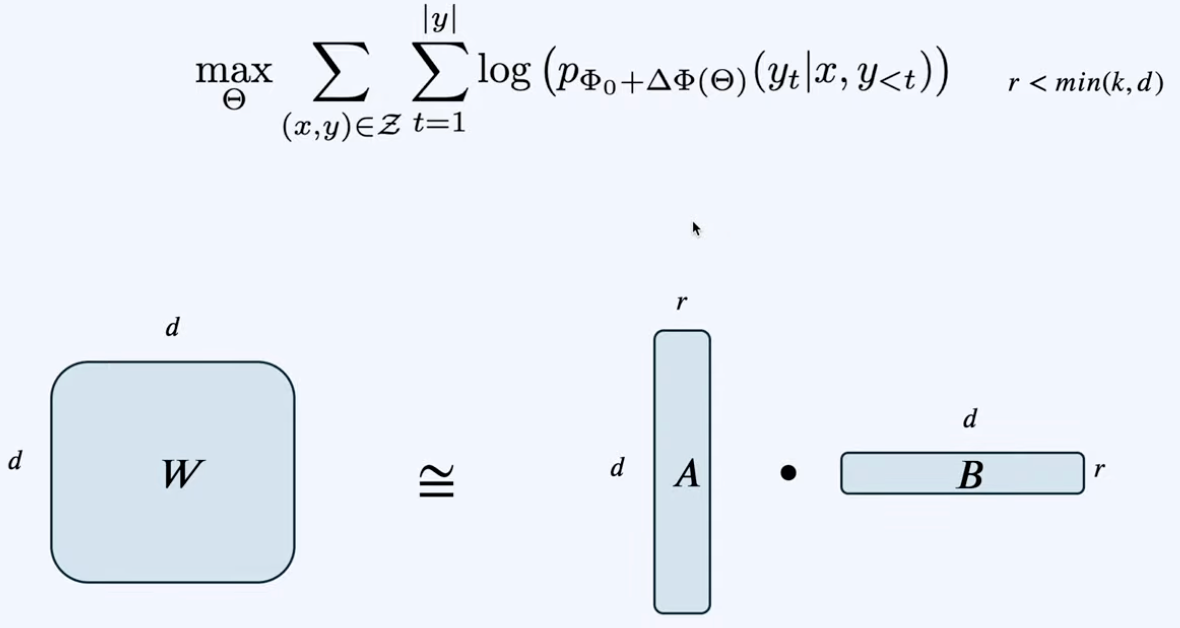
Low-Rank-Parameterized Update Matrices
Full Fine-tuning에서는 기존 가중치 $W_0$ 전체를 업데이트한다.
하지만 LoRA는 downstream task에 적응하기 위해 필요한 변화량 $\Delta W$로는 낮은 rank를 가질 수 있다고 가정한다.
Full Fine-tuning에서 필요할 weight update $\Delta W$ 를 low-rank 형태 $B\cdot A$로 근사한다.
선형종속적인 관계는 제외시키고, 적은 차원의 weight matrix만 쓰더라도 충분히 W를 근사하게 표현할 수 있다라는 것을 깔고 감.
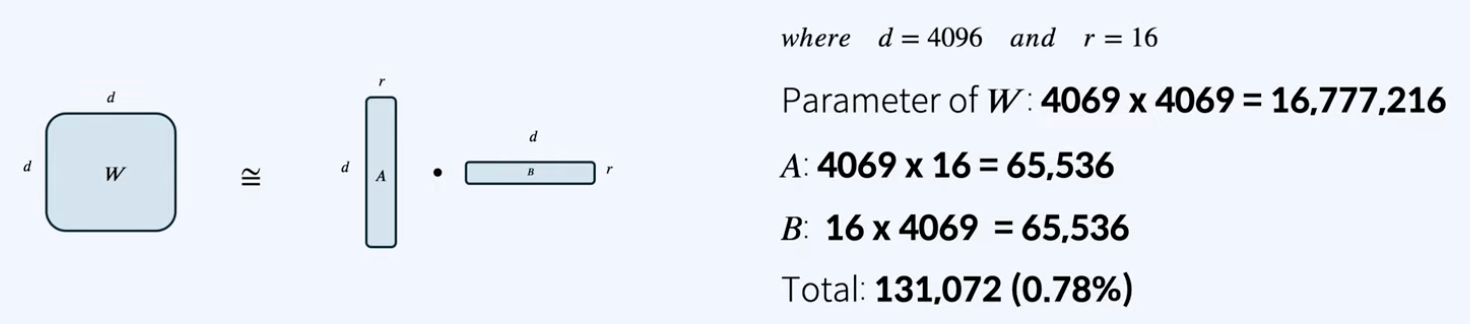
Forward Computation
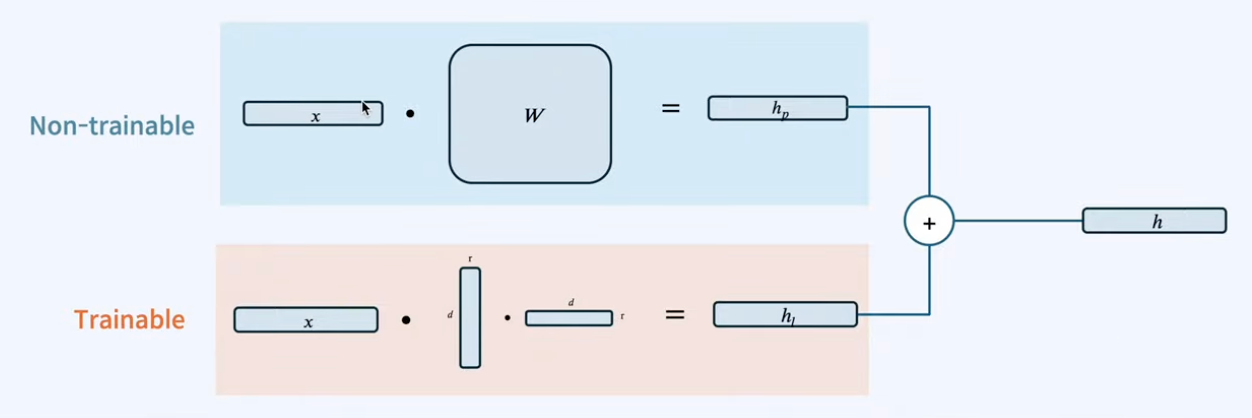
frozen pretrained path와 trainable low-rank path의 출력을 더해 최종 hidden representation $h$ 를 계산한다.
Training and Inference
Training
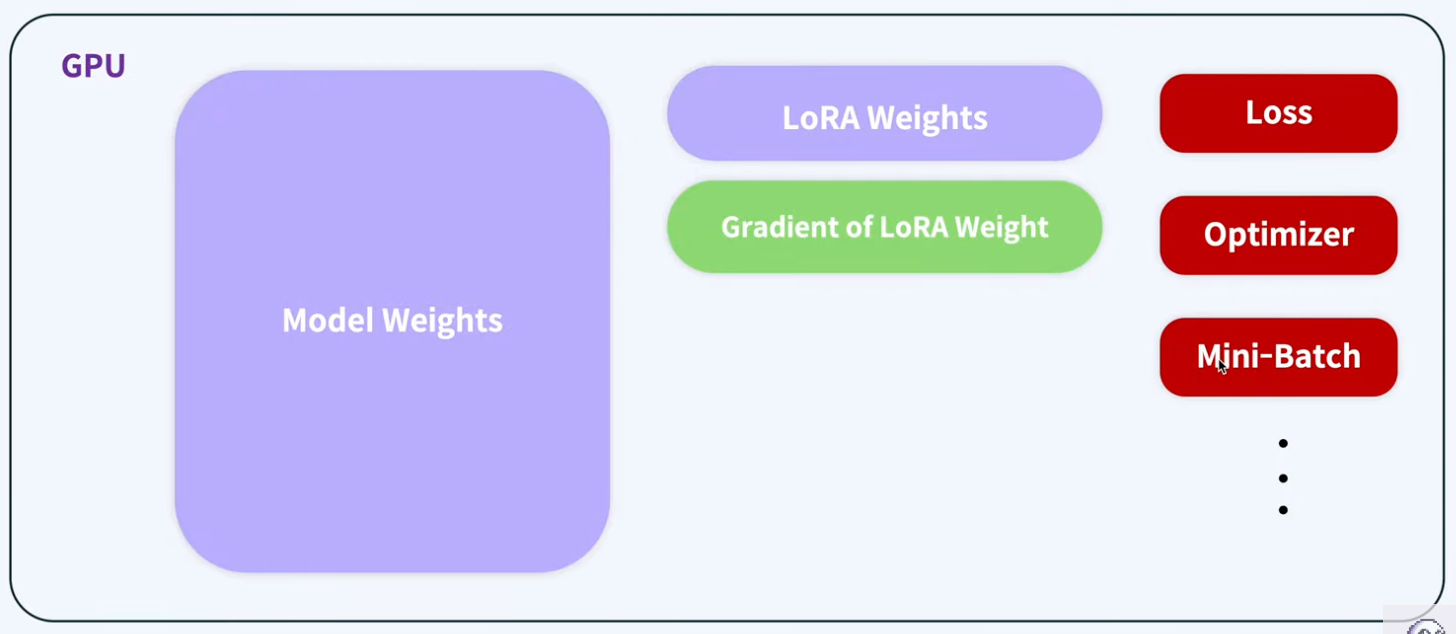
LoRA Weights 가 추가되지만, 학습 시 Gradient of LoRA weight만 Gradient로 넣어주면 되기 때문에 더 작은 weight만을 효과적으로 학습함.
Inference and Weight Merging
Inference 시, LoRA Weights 까지 같이 GPU에 올려야 해서 추가메모리와 추가연산이 존재함. (순수 inference와 비교 시)
하지만 LoRA는 Adapter와 달리 기존 weight와 병렬적인 low-rank branch로 학습되기 때문에 모델 깊이를 추가하지 않는다.
그리고 inference 시에는 이 low-rank update를 기존 weight에 merge할 수 있으므로, merge 후에는 별도의 추가 연산 없이 inference할 수 있다.
Experiments
Comparison with Fine-Tuning Baselines
근사를 하게 되면 성능이 떨어지는 것이 보편적이지만, 일반적인 Full Fine-tuning 보다도 LoRA가 성능도 일관적이고 성능이 좋은 경우가 다수.
Fine-tuning 을 하게 되면 기존의 weights가 일부 사라지기 때문에, 일반화 성능이 떨어질 수 있음.
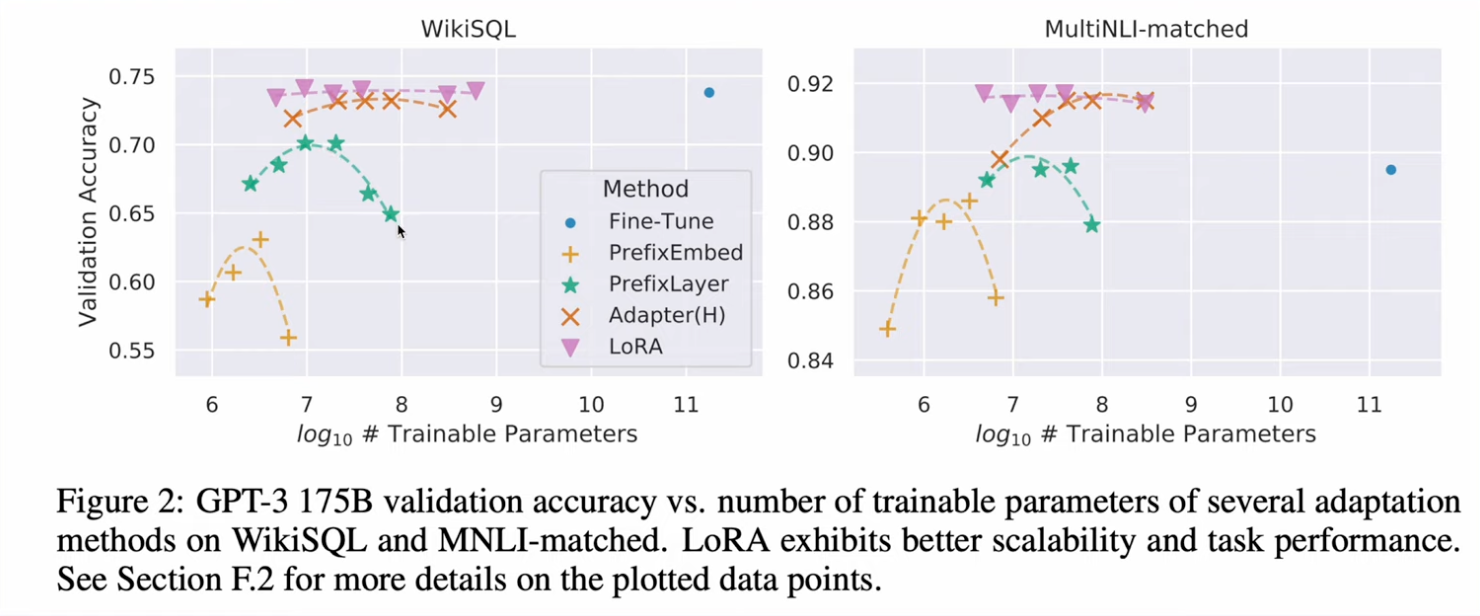
LoRA Fine-tuning은 기존 weight는 변화시키지 않고 LoRA Weight만 변화시키기 때문에 성능이 더 좋아질 수 있음을 알 수 있음.
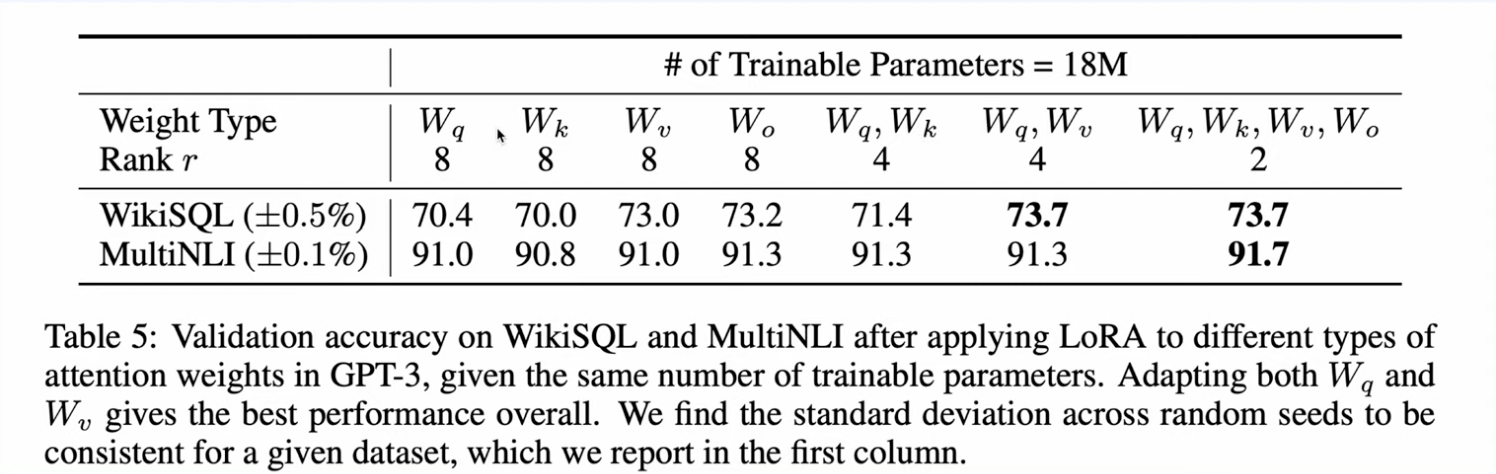
Which Weight Matrices Should LoRA Be Applied To?
What Is the Optimal Rank r for LoRA?
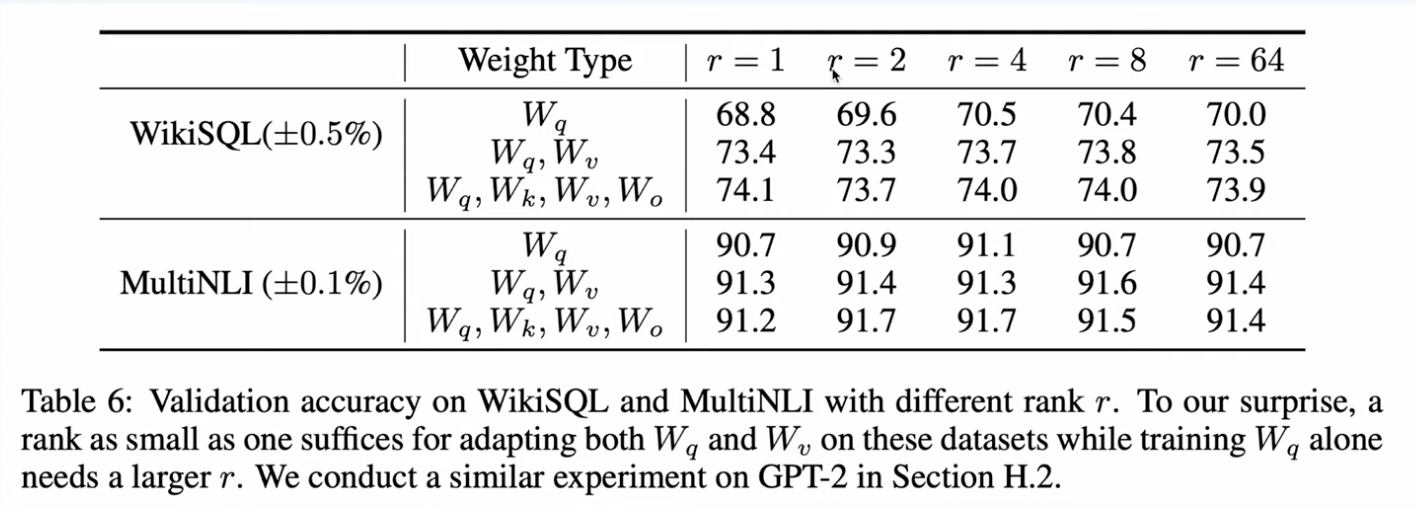
실험 결과, LoRA는 높은 rank가 반드시 필요하지 않았으며, 특히 $_q$ $W_v$에 함께 적용할 경우 매우 작은 rank만으로도 충분한 downstream adaptation 성능을 얻을 수 있었다. 이는 fine-tuning에서 필요한 weight update가 실제로 low-rank 구조를 가진다는 LoRA의 가정을 뒷받침한다.